- Inicio
- /
- Artículo

Gracias por sus comentarios.


 En este artículo
 ¿Comentarios?
La supervivencia mejorada proporciona una capacidad de conmutación por error de llamadas solo en las instalaciones en caso de una interrupción de la red del cliente o cualquier interrupción de la nube que impida que los usuarios de ese sitio se conecten a la instancia dedicada Webex Calling.
Descripción general
En el improbable caso de que una interrupción de la red, o cualquier otra interrupción le impida en el sitio conectarse a una instancia Webex Calling dedicada, el nodo de supervivencia mejorada se hace cargo activamente de las funciones de control de llamadas y enrutamiento. Webex CallingInstancia dedicada, implementación de Webex Calling múltiples inquilinos y local, todas tienen opciones de supervivencia, pero el documento de la solución detalla los aspectos a nivel de solución de supervivencia mejorada para instancia dedicada. Webex Calling
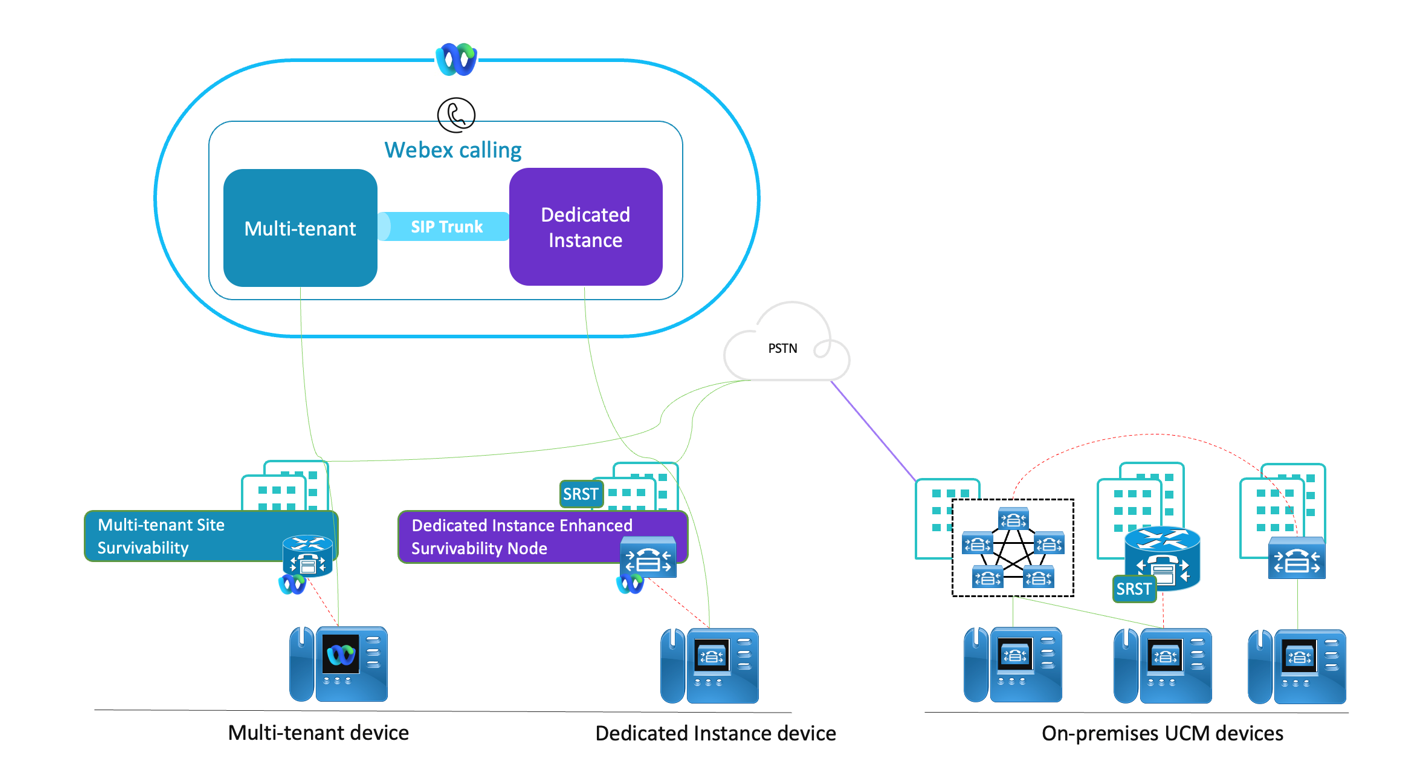
En la instancia dedicada, los suscriptores del Unified CM clúster se implementan en todo el centro de datos dentro de una región, para proporcionar alta disponibilidad y redundancia geográfica. Permite que los dispositivos o el cliente realicen una conmutación por error al suscriptor en el otro centro de datos. Pero, si hay una interrupción de la red entre su sitio y la nube de instancia dedicada, el nodo de supervivencia mejorada que se implementa dentro del sitio puede manejar las funcionalidades de control de llamadas y enrutamiento hasta que se restaure la conectividad. El nodo de supervivencia mejorado (ESN) proporciona las funcionalidades de control de llamadas de un suscriptor estándar durante un evento de interrupción.
El nodo de supervivencia mejorada solo puede enrutar llamadas dentro de un sitio y para otras llamadas, debe enrutar a través de PSTN para lo cual debe implementar una puerta de enlace local dentro del sitio para PSTN. Requiere que configure un servidor DNS local para el ESN para las resoluciones, ya que el ESN no puede llegar al servidor DNS de Cisco durante la interrupción. El nodo de supervivencia mejorada también puede coexistir con Cisco SRST.
Modelos de despliegue
Un solo sitio
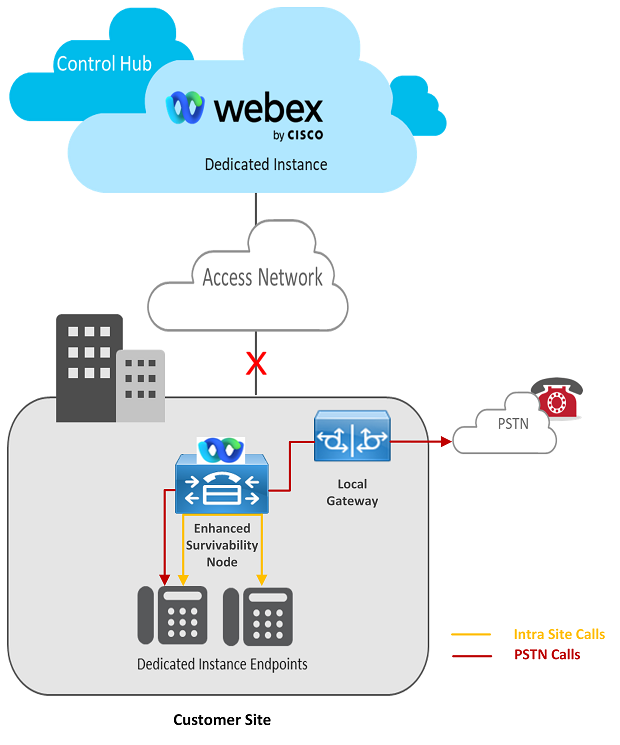
En el modelo de implementación de un solo sitio, donde se implementa un nodo de supervivencia mejorado (ESN) dentro de un sitio junto con una puerta de enlace local para el enrutamiento de llamadas PSTN. Se puede registrar un máximo de 7500 dispositivos en el ESN durante una interrupción.
Múltiples sitios
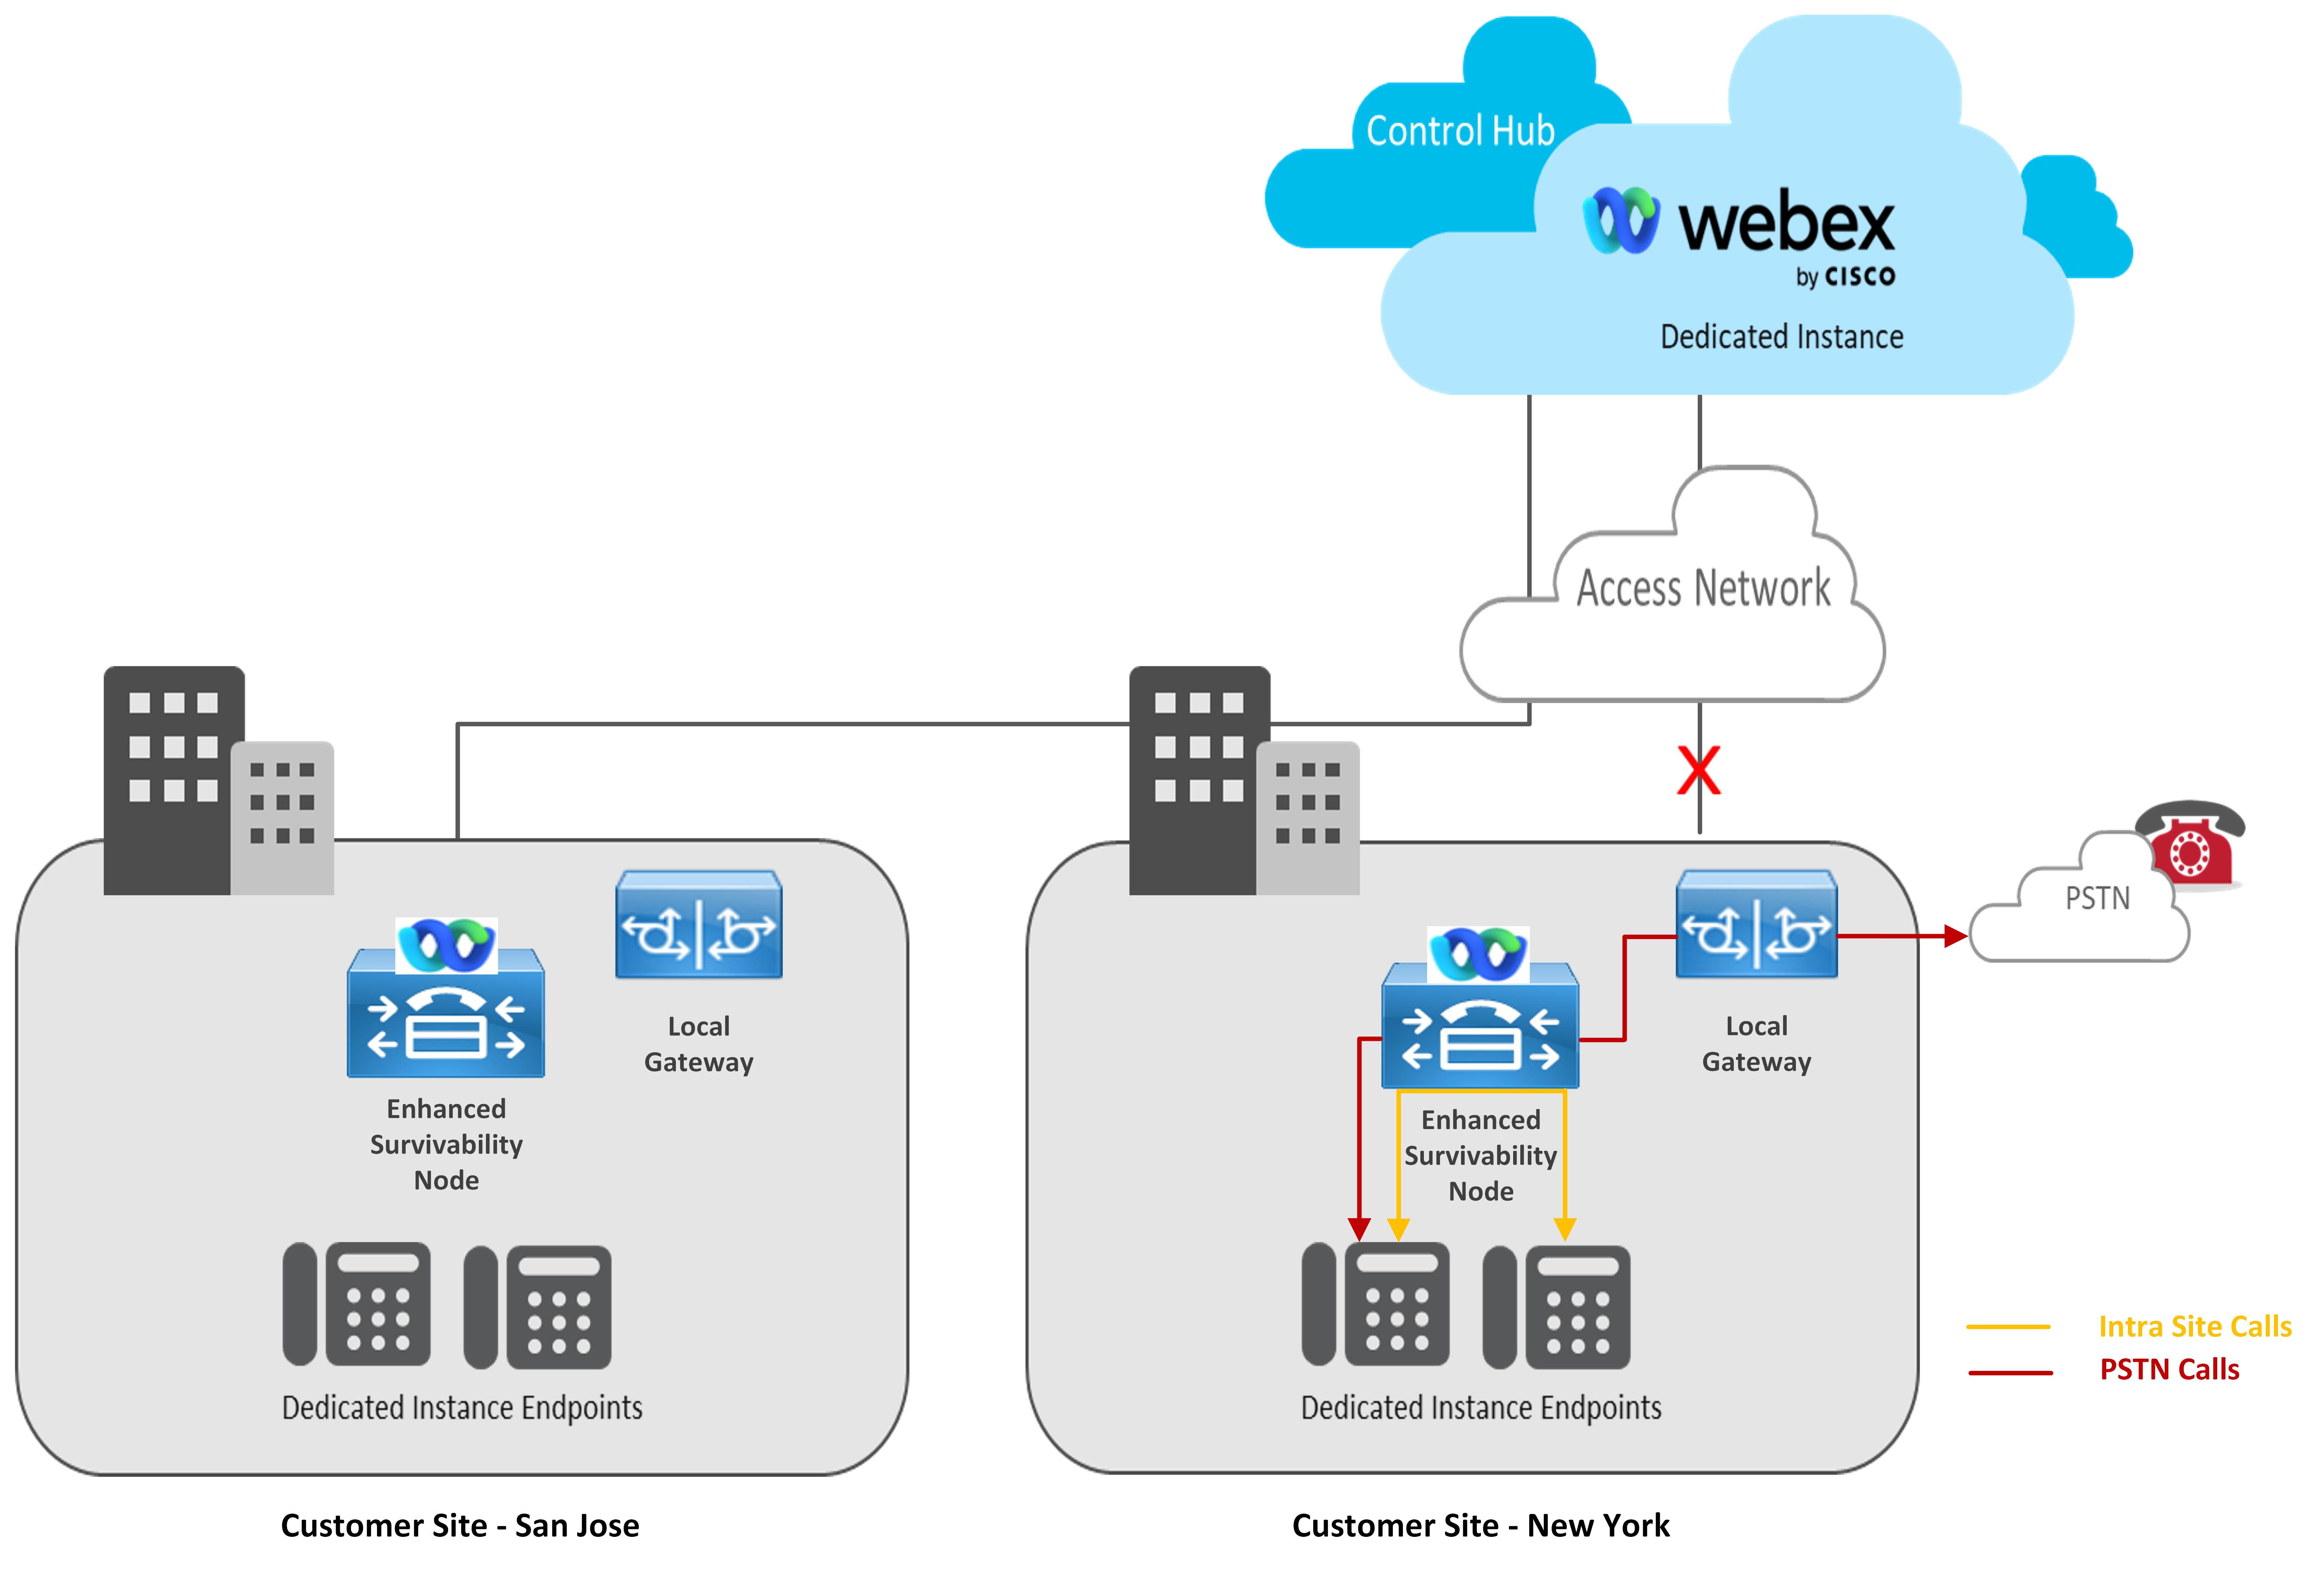
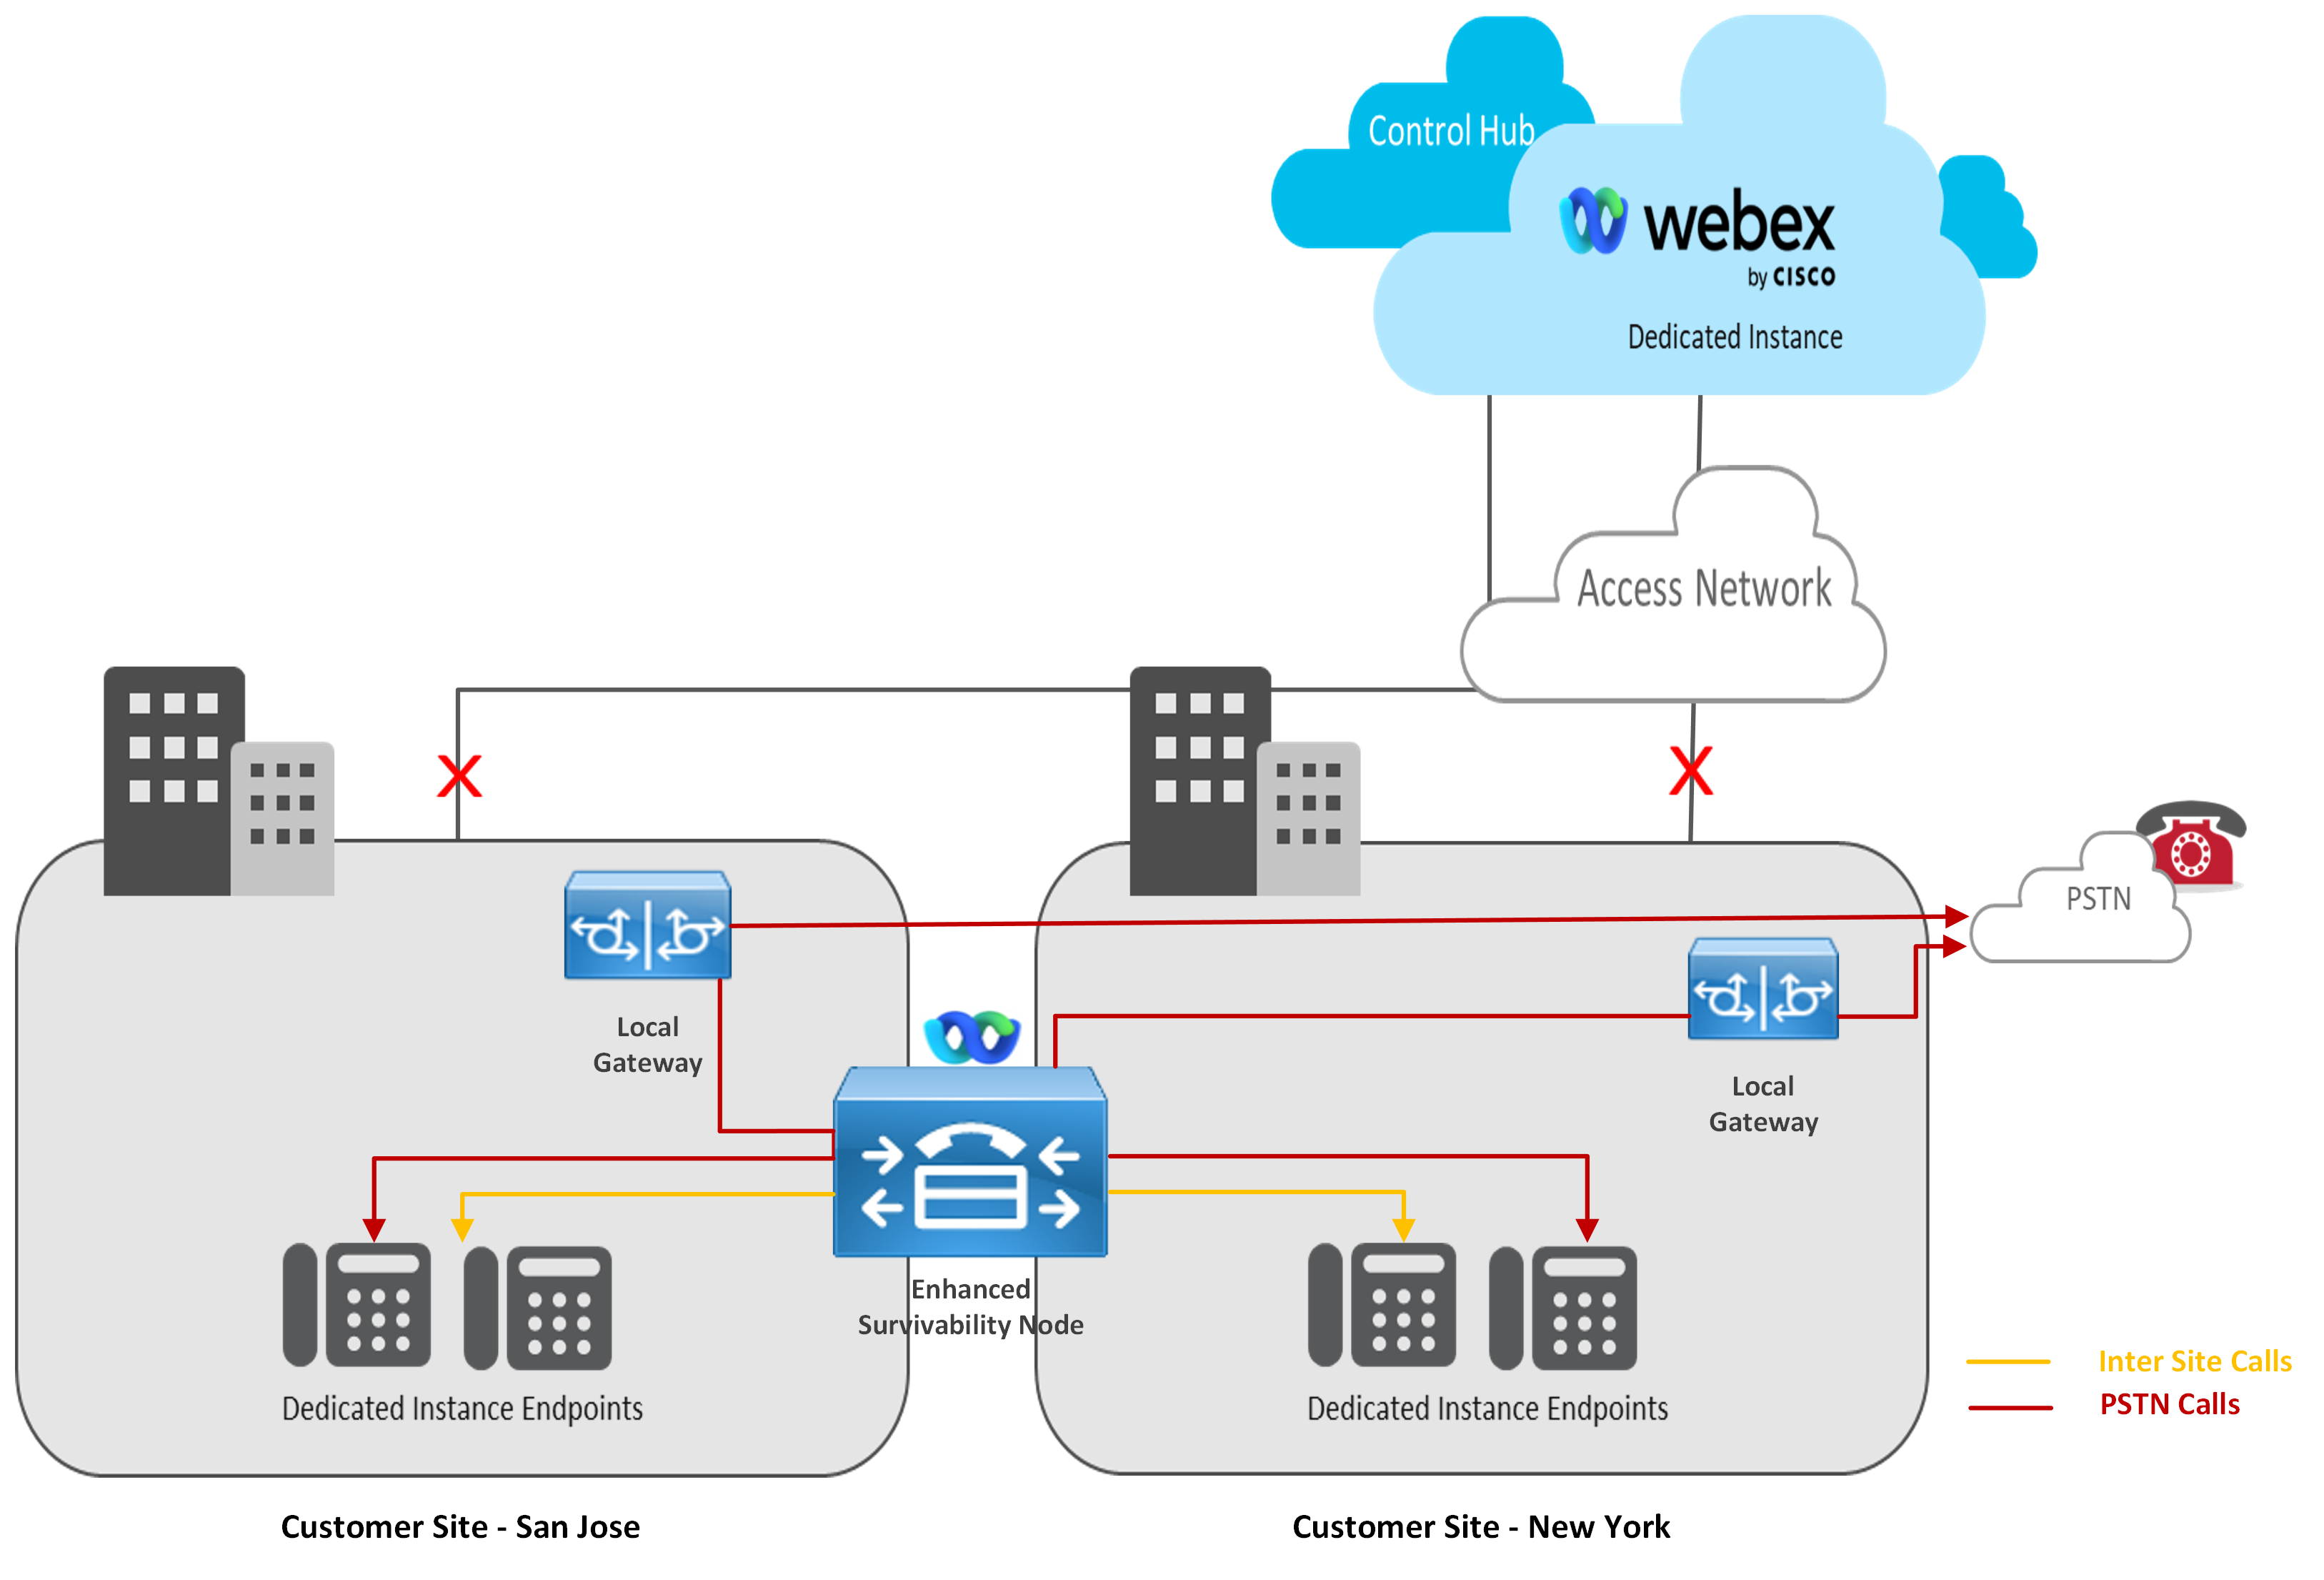
En el modelo de implementación de múltiples sitios, donde hay varios sitios y ESN se puede implementar en cada sitio depende de los requisitos comerciales para la supervivencia del sitio. Los requisitos de una puerta de enlace local y DNS son siempre una necesidad y se pueden agregar un total de 8 nodos ESN a un Unified CM clúster.
Este modelo de implementación es relevante para un cliente en una región con múltiples sitios y la capacidad de supervivencia es un requisito para varios de esos sitios. Si bien es posible compartir la puerta de enlace local PSTN entre sitios, no se recomienda. Si hay una interrupción de la red, el sitio puede aislarse y, en ese caso, ESN no podrá llegar a la puerta de enlace local para enrutar las llamadas a PSTN.
A continuación se presentan 2 opciones de implementación para una implementación en varios sitios:
-
Opción 1: Nodo de supervivencia mejorado implementado en cada sitio.
-
Opción 2: Nodo de supervivencia mejorado común compartido entre varios sitios.
Capacidad de servicio
Monitoreo
Supervisamos y administramos el nodo de supervivencia mejorada como otros nodos que se implementan en el centro de datos de instancia dedicada. Durante un evento de supervivencia, cuando el ESN se desconecta del IS, cuando perdemos el Cisco Cloud acceso al Nodo y nos conectamos automáticamente cuando se resuelve la interrupción y se restablece la conectividad.
Administración de certificados
Gestionamos los certificados de aplicación UC y durante la activación del nodo de supervivencia mejorada actualizamos el certificado de Unified CM clúster de instancia dedicada se actualiza con el ESN.
Durante la activación del ESN desde Control Hub, se reiniciará todos los dispositivos registrados, ya que el certificado para el Unified CM clúster se actualizará con los certificados multi-SAN. Por lo tanto, planificamos el período de mantenimiento durante la activación del ESN desde Control Hub. Refiera, Cómo activar el nodo de supervivencia mejorada.
CDR
Durante el evento de supervivencia, el nodo de supervivencia mejorada almacena todos los datos de CDR/CMR localmente. Cuando se restaure la conectividad, los datos se sincronizarán de nuevo con el Unified CM editor de instancias dedicadas. La cantidad de datos que se pueden almacenar se basa en el tamaño del disco del nodo de supervivencia mejorado. El espacio máximo de asignación de disco que se puede establecer para CDR es de 3328 MB. Esto puede ser con un tamaño de archivo CDR pequeño a grande basado en el intervalo CDR configurado. La purga se realiza en base a:
-
Cuando el uso del disco excede el espacio en disco asignado o configurado, entonces elimina los registros procesados. Si el uso del disco sigue siendo mayor, es cuando también se purgan los registros sin procesar.
-
Alto porcentaje de marca de agua que se configura en la configuración de “Administración de CDR”, los archivos CDR se purgarán. Por ejemplo, si el “% de marca de agua alta” está configurado como 80% y el uso del disco es 80%, entonces los archivos CDR se purgarán.
-
Conservación de archivos CDR/CMR Duración (días) que se configura en la configuración de “Administración de CDR”, los archivos CDR se depurarán. De forma predeterminada, se establece en 30 días.
Alarmas RTMT
Las siguientes son las alertas en RTMT relacionadas con el nodo de supervivencia mejorada:
-
SurvivabilityEvent: la alarma se activa cuando no se puede acceder a todos los nodos de instancia dedicada desde el nodo de supervivencia mejorada.
-
RemoteSurvivableNodeNotreachable: la alarma se activa cuando no se puede acceder a un nodo de supervivencia mejorada desde el editor de instancias dedicadas. Unified CM
Contador de rendimiento
Durante el evento de supervivencia, debe conectar RTMT al nodo de supervivencia mejorada para monitorear el rendimiento del ESN. Lo mismo no estará disponible, si RTMT está conectado a los nodos de instancia dedicada, ya que el ESN no será accesible desde la nube durante el evento de supervivencia.
Unified CMcaracterísticas y configuración
Configuración de usuario
Durante el funcionamiento normal, la replicación de la base de datos está completamente interconectada entre todos los servidores, incluido el nodo de supervivencia mejorada dentro del Unified CM clúster. Los datos de configuración estática, ya que se crean a través de movimientos, adiciones y cambios, siempre se almacenan en el editor y se replican de una manera desde el editor a cada suscriptor y nodo de supervivencia mejorada en el clúster.
Durante un evento de supervivencia, solo se modifican las características orientadas al usuario en los dispositivos que están registrados en el nodo de supervivencia mejorada y las características orientadas al usuario generalmente se caracterizan por el hecho de que puede habilitar o deshabilitar una función directamente en su teléfono presionando uno o más botones, en lugar de cambiar una característica a través de una GUI basada en la web. Por lo tanto, el nodo de supervivencia mejorada permite el autocuidado y la GUI de administración web como operaciones de solo lectura. Los dispositivos del usuario registrados en ESN solo pueden realizar cambios en las características orientadas al usuario que se enumeran a continuación durante la conmutación por error. Sin embargo, estos cambios no se sincronizarán de nuevo con el Unified CM editor DI cuando se restablezca la conectividad.
Las características orientadas al usuario son cualquier característica que se puede habilitar o deshabilitar presionando botones en el teléfono e incluyen lo siguiente:
-
Desenvío de llamadas a todos (CFA)
-
Privacidad Habilitar o Deshabilitar
-
No molestar (DND) Activar o deshabilitar
-
Cisco Extension MobilityIniciar sesión
-
Inicio de sesión o cierre de sesión del grupo de caza
-
Movilidad del dispositivo
-
Estado CTI CAPF para usuarios finales y usuarios de aplicaciones.
Autenticación
La autenticación de clientes flexibles (Cisco Jabbery Webex Application) para el inicio de sesión durante la conmutación por error al nodo de supervivencia mejorada es la siguiente:
-
Autenticación local: Cuando la autenticación de los usuarios se realiza localmente dentro deUnified CM, durante el evento de supervivencia, el nodo de supervivencia mejorada podrá autenticar a los clientes registrados en él.
-
Autenticación LDAP: En este caso, la autenticación de los usuarios se realiza mediante el servidor LDAP local. Luego, durante el evento de supervivencia, la autenticación de clientes flexibles funcionará siempre que se pueda acceder al servidor LDAP desde el nodo de supervivencia mejorada.
Debe asegurarse de que el directorio LDAP sea alcanzable a ESN durante todo el evento de supervivencia.
-
Autenticación de inicio de sesión único (SSO): La autenticación de inicio de sesión SSO de los usuarios se realiza mediante el servidor IDP. Luego, durante el evento de supervivencia, la autenticación de clientes flexibles funciona siempre que se pueda acceder al servidor IDP desde el nodo de supervivencia mejorada.
Para el inicio de sesión de interfaz de usuario Unified CM web habilitado para SSO, se requiere la capacidad de acceso de IDP o se debe usar el inicio de sesión de URL basado en recuperación.
Los clientes ya autenticados continúan iniciando sesión ya que la autenticación se basa en el token que se obtiene antes del evento de supervivencia. Sin embargo, para nuevos inicios de sesión cuando el cliente no tiene un token válido de la autenticación anterior, el ESN redirigirá al servidor IDP para la autenticación. Por lo tanto, siempre es necesario garantizar la capacidad de acceso del servidor IDP a ESN durante todo el evento de supervivencia.
Recursos para medios
Los recursos multimedia son necesarios para Unified CM las funciones básicas, como Music on Hold, Anuncio, Conference Bridge (software), los servicios deben estar habilitados en el ESN. Si se implementaron recursos de medios basados en hardware, durante el evento de supervivencia debe asegurarse de que los servidores de medios sean accesibles desde el ESN.
Llamadas de emergencia
Durante las operaciones normales del Unified CM clúster DI, las llamadas de emergencia (particularmente en la región AMER) se enrutan a través de la nube RedSky, donde hay un enlace troncal SIP que se configura entre el clúster CM unificado de instancia dedicada y la nube RedSky.
Si hay un evento de supervivencia, no se podrá acceder a la nube RedSky desde el ESN y, por lo tanto, es necesario que configure el plan de marcado de llamadas de emergencia de modo que, si RedSky no está disponible, enrute las llamadas de emergencia a través de la PSTN GW local configurada en ese sitio. El grupo de ruta debe consistir en el PSTN GW local para manejar el enrutamiento de llamadas durante el evento de supervivencia.
Para llamadas de emergencia en otras regiones de instancias dedicadas, también es necesario configurar el plan de marcado para enrutar las llamadas a través de PSTN GW local durante el evento de supervivencia.
Enrutamiento de llamadas
Configure el plan de marcado para enrutar llamadas intrasitas, intersitio, intercluster y PSTN durante el evento de supervivencia. En general, el ESN puede enrutar llamadas solo para dispositivos que están registrados en él. Todas las demás llamadas deben enrutarse a la PSTN GW local (configurada en cada sitio donde se implementa ESN) y desde allí a la PSTN. A continuación se explican algunos escenarios:
-
El teléfono 1 y el teléfono 2 están registrados en el mismo ESN: la llamada se enruta dentro del ESN.
-
Teléfono 1 registrado en ESN y Teléfono 2 registrado en el Unified CM clúster de instancia dedicada: el plan de marcado debe enrutar las llamadas desde ESN a la PSTN GW local, de allí a la DI a través de PSTN. Unified CM Durante el evento de supervivencia, el plan de marcado debe detectar el error de enrutamiento de llamadas y redirigir las llamadas a través de la GW PSTN local. Lo mismo debería aplicarse a las llamadas entrantes a ESN desde Unified CM dispositivos DI.
-
El teléfono 1 registrado en ESN y el teléfono 2 es un dispositivo PSTN: durante un evento de supervivencia, las llamadas PSTN deben enrutarse a la puerta de enlace PSTN local. Debe asegurarse de que el plan de marcado tenga la capacidad de detectar errores de enrutamiento de llamadas y redirigir la llamada a través de la puerta de enlace PSTN local disponible.
No recomendamos llamadas ICT entre 2 nodos de ESN, aunque es factible cuando los ESN son accesibles dentro de su red.
Correo de voz y asistente automático
-
Durante el evento de supervivencia, cuando la conectividad de su sitio a la nube de instancia dedicada está inactiva (WAN o interrupción de conectividad), las funciones de correo de voz y de asistente automático no funcionarán para los dispositivos que se registran en el ESN, ya que el Cisco Unity Connection servidor está alojado en la nube de instancia dedicada a la que la conectividad de ESN está inactiva. Si su dispositivo está configurado con “Reenvío de llamada no registrado (CFU)” y la llamada se recibe en DIUnified CM, entonces la persona que llama puede depositar un correo de voz en la Conexión Unity de instancia dedicada. Que se puede recuperar cuando los dispositivos vuelven a los suscriptores de CM unificados DI.
-
Sin embargo, durante un evento de supervivencia cuando la conectividad a la nube de instancia dedicada está disponible pero el Unified CM clúster en DI está inactivo, en ese caso las funciones de correo de voz y de asistente automático funcionan para dispositivos registrados en ESN, ya que ESN tendrá conectividad con el servidor de Unity Connection implementado en la nube DI.
Móvil y Remote Access (MRA)
Durante el evento de supervivencia, el ESN no podrá alcanzar el Cisco Expressway E & C en la nube DI y viceversa. Entonces, en este caso, los usuarios de MRA no pueden obtener el servicio de ESN y, por lo tanto, no podrán registrarse. Sin embargo, si el dispositivo MRA tiene Internet y puede conectarse a Cisco Expressways en la nube DI, entonces puede registrarse con el DI Unified CM siempre que el clúster en DI sea funcional.
Integraciones de terceros
CTI
Para que las integraciones basadas en CTI funcionen con el nodo de supervivencia mejorado, debe agregar el nodo de supervivencia mejorado como parte de la lista de servidores de CTI. Las mejoras de CTI se realizan para aplicaciones que usan JTPI para permitir el Nodo de supervivencia mejorada como un servidor CTI al que la aplicación puede conectarse solo en caso de que no se pueda acceder a los servidores CTI primario o secundario de la lista configurada. Durante una operación normal, las aplicaciones CTI en el sitio pueden conectarse con los servidores CTI primario y secundario en la nube DI y durante el evento de supervivencia, pueden conectarse con el nodo de supervivencia mejorado para una experiencia continua de CTI. Las aplicaciones deben adaptarse a las nuevas API tal como se exponen a través de la interfaz JTAPI para garantizar que se realice una recuperación del nodo de supervivencia mejorada cuando se restaure la conectividad.
Para obtener más información sobre las nuevas API agregadas, consulte la sección de redundancia, https://www.cisco.com/c/en/us/td/docs/ voice_ip_comm /cucm/ /14_0_1/ -unified-jtapi-developers-guide-14/ jtapi_dev -unified-jtapi-developers-guide-1251_chapter_00.html cucm_b_cisco cucm_b_cisco
SIP de terceros
Las aplicaciones de terceros que se interaccionan a través de los troncales SIP son compatibles con el nodo de supervivencia mejorado. En las configuraciones troncales SIP, la configuración 'ejecutar en todos los nodos' debe estar habilitada.
Teléfonos de terceros
Se admiten dispositivos de terceros que tienen capacidad TFTP terciaria.
Recuperación ante desastres
Si la capacidad de supervivencia mejorada está dañada o no se puede reparar, siga los pasos a continuación para volver a implementar el nodo de supervivencia mejorada:
-
Plantee un caso de soporte de Cisco TAC. Luego, las operaciones de Instancia Dedicada ayudarán a eliminar el nodo de supervivencia mejorada afectado del nodo del editor de Instancia dedicada en Control Hub.
-
Desde el centro de control, una vez que el sistema elimina el nodo de supervivencia mejorada dañado en el Unified CM editor de instancia dedicada, siga los mismos pasos mencionados en Agregar nodo de supervivencia mejorada, Instalar nodo de supervivencia mejorada y Activar nodo de supervivencia mejorada para reactivar el nodo dañado y volver a agregarlo al clúster de instancia dedicada.
Una vez que el nodo se vuelve a agregar al clúster, la sincronización de la base de datos se activa automáticamente y el nodo se restaura.
Cuando vuelva a agregar el nodo de supervivencia mejorada en Control Hub, Control Hub conservará el nombre de host del nodo dañado en Agregar nodo de supervivencia mejorada. Puede optar por conservar o cambiar la dirección IP.


