
Obrigado pelos seus comentários.
 Comentários?
As notificações no Control Hub são um local central para gerenciar alertas para sua implantação do Webex. Os administradores podem configurar alertas para serem entregues por e-mail, webhooks, PagerDuty ou em um espaço do aplicativo Webex. Independentemente do canal de entrega configurado, todos os alertas sempre aparecerão no Control Hub.
Cada administrador tem seu próprio conjunto de alertas e regras que pode criar e visualizar nas guias Meus alertas e Minhas regras, e pode visualizar todos os alertas e regras de outros administradores da organização nas guias Todos os alertas e Todas as regras.
Os alertas dos últimos 14 dias aparecerão na seção Alertas. Você pode exportar alertas históricos dos últimos 30 dias em formato CSV clicando no botão exportar.
Os alertas que ocorrem no mesmo dia e têm a mesma gravidade, tipo e alvo são agrupados em um menu suspenso dobrável para facilitar a visualização e a navegação. Você pode passar o mouse sobre o botão de expansão para ver como os alertas foram combinados.
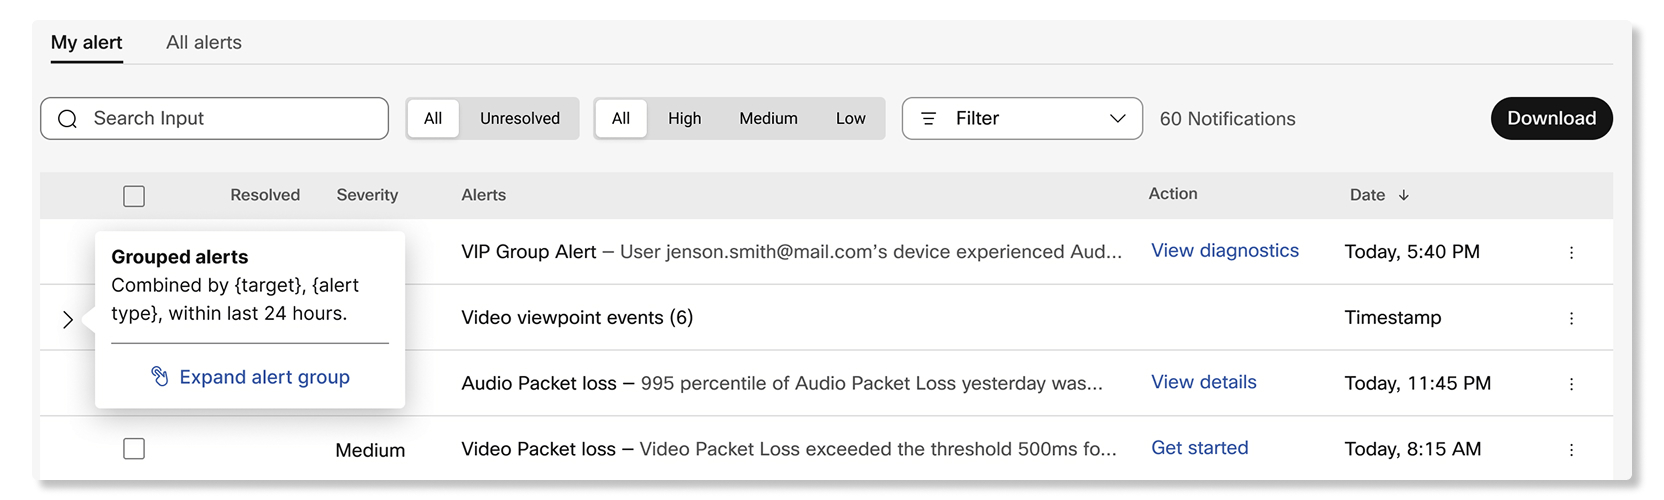
Há duas categorias de alertas: baseados em limites e gerados por serviços.
Alertas baseados em limites
Os administradores podem criar uma regra para monitorar eventos específicos especificando limites específicos, como participantes que atingem mais de 300 ms de latência ou uma perda de pacotes de mais de 8%. Esses alertas só são acionados se os administradores os configurarem criando uma regra.
Os administradores podem configurar ainda mais como esses alertas são entregues escolhendo o canal de entrega para eles:
- E-mail — Você pode adicionar até 30 endereços de e-mail como destinatários para receber os alertas.
-
Aplicativo Webex —Você pode receber o alerta em um novo espaço, um espaço existente ou em um
espaço 1:1.
Se um espaço existente for renomeado, o alerta ainda será entregue no mesmo espaço.
- Webhook — Os alertas serão enviados para o URL do webhook configurado no Control Hub.
- PagerDuty — Você pode inserir uma chave de serviço para entregar os alertas a um serviço relacionado usando o PagerDuty.
Alertas gerados pelo serviço
Esses alertas são criados automaticamente pelos serviços Webex. A maioria desses alertas é de natureza crítica e aos quais o administrador deve prestar atenção. Os administradores podem gerenciar a forma como esses alertas são entregues escolhendo o canal de entrega para eles, semelhante aos alertas baseados em limites. Os canais de entrega incluem e-mail, aplicativo Webex, webhook e PagerDuty.
Exibir alertas e regras
| 1 |
Faça login no Control Hub e acesse Notificações. |
| 2 |
Selecione uma das seguintes opções:
|
Encontre alertas por alvo
Use a coluna Alvo para ver qual dispositivo, espaço de trabalho, usuário, tronco ou outro alvo um alerta afeta. Pesquise pelo nome do alvo para encontrar alertas relacionados.
Um alvo aparece somente quando as informações do alvo estão disponíveis para o alerta.
| 1 |
Entre no Control Hub e acesse . |
| 2 |
Selecione Todos os alertas ou Meus alertas. |
| 3 |
Verifique na coluna Alvo o alvo afetado. |
| 4 |
Insira um nome de destino no campo de pesquisa para encontrar alertas correspondentes. |
Entenda um tipo de alerta
Leia uma explicação sobre um tipo de alerta no painel lateral para saber o que o alerta significa.
As descrições não estão disponíveis para todos os tipos de alerta.
| 1 |
Entre no Control Hub e acesse . |
| 2 |
Selecione Todos os alertas ou Meus alertas e abra um alerta. |
| 3 |
Se um ícone de informações aparecer ao lado de Tipo, use-o para ler a explicação. |
ParaWebex Meetings, você pode criar regras para receber alertas para:
- Monitoramento de reuniões ao vivo — Use esse alerta para descobrir quando os participantes estão enfrentando problemas de qualidade de mídia durante as reuniões que estão em andamento. Você pode criar até 10 desses alertas.
- Monitoramento de reuniões ao vivo por dispositivo — use esse alerta para descobrir quando os dispositivos estão enfrentando problemas de qualidade de mídia durante as reuniões que estão em andamento. Você pode criar até 25 desses alertas.
- Tendência histórica da qualidade da reunião — Use esse alerta para descobrir quando uma porcentagem de participantes em sites e locais específicos do Webex atinge os limites de qualidade de mídia que são definidos automaticamente com base no desempenho anterior das reuniões nos últimos sete dias. Você pode criar até 10 desses alertas.
- Monitoramento da qualidade da reunião histórica — Semelhante ao alerta de tendência de qualidade da reunião histórica, você pode usar esse alerta para definir seus próprios limites de quando receber um alerta quando uma porcentagem de participantes em sites e locais específicos do Webex atingir qualquer um dos limites de qualidade de mídia. Você pode criar até 10 desses alertas.
Os alertas de reunião são acionados apenas para participantes que participam de reuniões por meio Webex Meetings de um aplicativo Webex. As versões mínimas do aplicativo que os participantes devem usar para que os alertas sejam acionados são:
-
Webex Meetingsaplicativo de desktop versão 39.6.5 ou superior
-
Webex Meetingsaplicativo móvel para Android e iOS versão 39.11 ou superior
-
Versão de desktop do aplicativo Webex 3.0.12427.0 ou superior
-
Versão Android móvel do aplicativo Webex 4.1.6 ou superior
-
Webex App mobile iOS versão 4.3 ou superior
Os alertas não são acionados para reuniões somente de áudio, eventos Webex e sessões de treinamento Webex.
Você pode ativar até 10 alertas de monitoramento de reuniões ao vivo por organização. Cada alerta pode monitorar até 30 endereços de e-mail de usuários ou 30 dispositivos.
Se a caixa de seleção Monitorar todos os participantes estiver marcada, o alerta será acionado somente para reuniões com menos de 50 participantes.
| 1 |
Entre no Control Hub e acesse Notificações > Minhas regras. |
| 2 |
Clique em Criar regra. |
| 3 |
Selecione Monitoramento de reuniões ao vivo ao lado de Tipo e insira o nome do alerta ao lado de Título. |
| 4 |
Ative o botão Status para receber notificações do alerta. |
| 5 |
Selecione E-mail (s) do usuário ou Nome (s) do dispositivo e insira até 30 endereços de e-mail ou dispositivos do usuário. |
| 6 |
Marque a caixa de seleção Monitorar todos os participantes para receber alertas para todos os participantes que estão nas mesmas reuniões que os usuários ou dispositivos da lista. |
| 7 |
Na seção Regras, defina os seguintes limites:
|
| 8 |
Defina a duração acumulada e consecutiva para que o alerta seja acionado. |
| 9 |
Na seção Canal de entrega, marque a caixa de seleção E-mail e insira os endereços de e-mail de quem receberá os alertas. |
| 10 |
Marque a caixa de seleção Webex Space e insira o nome do espaço se quiser receber mensagens nesse espaço sempre que um limite for atingido. |
| 11 |
Clique em Salvar. |
Você pode ativar até 25 alertas de monitoramento de reuniões ao vivo por dispositivo por organização.
| 1 |
Entre no Control Hub e acesse Notificações > Minhas regras. |
| 2 |
Clique em Criar regra. |
| 3 |
Selecione Monitoramento de reuniões ao vivo do dispositivo ao lado de Tipo e insira o nome do alerta ao lado de Título. |
| 4 |
Ative o botão Ativado para receber notificações do alerta. |
| 5 |
Escolha monitorar:
|
| 6 |
Na seção Regras, defina os seguintes limites de áudio e vídeo:
|
| 7 |
Defina a duração acumulada e consecutiva para que o alerta seja acionado. |
| 8 |
Na seção Canal de entrega, você pode:
|
| 9 |
Clique em Salvar. |
Você pode adicionar até 10 alertas históricos de tendências de qualidade de reuniões por organização.
| 1 |
Entre no Control Hub e acesse Notificações > Minhas regras. |
| 2 |
Clique em Criar regra. |
| 3 |
Selecione Tendência histórica da qualidade da reunião ao lado de Tipo e insira o nome do alerta ao lado de Título. |
| 4 |
Ative o botão Status para receber notificações do alerta. |
| 5 |
Selecione para quais sites Webex e locais de participantes receber alertas. |
| 6 |
Na seção Canal de entrega, marque a caixa de seleção E-mail e insira os endereços de e-mail de quem receberá os alertas. |
| 7 |
Marque a caixa de seleção Webex Space e insira o nome do espaço se quiser receber mensagens nesse espaço sempre que um limite for atingido. |
| 8 |
Clique em Salvar. |
Você pode ativar até 10 alertas históricos de monitoramento da qualidade de reuniões por organização.
| 1 |
Entre no Control Hub e acesse Notificações > Minhas regras. |
| 2 |
Clique em Criar regra. |
| 3 |
Selecione Monitoramento histórico da qualidade da reunião ao lado de Tipo e insira o nome do alerta ao lado de Título. |
| 4 |
Ative o botão Status para receber notificações do alerta. |
| 5 |
Selecione para quais sites Webex e locais de participantes receber alertas. |
| 6 |
Na seção Regras, defina os seguintes limites:
|
| 7 |
Na seção Acionador, selecione uma duração para monitorar e insira a porcentagem de participantes que devem atingir um dos limites para acionar o alerta. |
| 8 |
Na seção Canal de entrega, marque a caixa de seleção E-mail e insira os endereços de e-mail de quem receberá os alertas. |
| 9 |
Marque a caixa de seleção Webex Space e insira o nome do espaço se quiser receber mensagens nesse espaço sempre que um limite for atingido. |
| 10 |
Clique em Salvar. |
ParaWebex Calling, você pode configurar os seguintes alertas:
Adicionar um alerta de queda na qualidade da chamada
Use esse alerta para descobrir quando a qualidade da chamada em locais específicos ou a sessão de mídia de um usuário cai para baixa qualidade.
A qualidade da chamada é calculada como:
- Bom — Tanto o fluxo de vídeo quanto o de áudio tiveram instabilidade abaixo de 150 ms, latência abaixo de 400 ms e perda de pacotes abaixo de 5%.
- Ruim — Tanto o fluxo de vídeo quanto o de áudio tiveram instabilidade acima de 150 ms, latência acima de 400 ms e perda de pacotes acima de 5%.
Os alertas são enviados quando uma chamada termina. Ao receber o alerta, você pode clicar em Solucionar problemas de chamada para ir direto para a chamada em Solução de problemas se o alerta estiver monitorando usuários específicos. Se o alerta estiver monitorando locais, você pode clicar em Exibir análises para acessar a guia Qualidade de mídia no Calling Analytics.
Você pode criar até 10 alertas de queda na qualidade da chamada por organização.
Os alertas não são acionados em troncos baseados em Instância Dedicada (DI).
| 1 |
Faça login no Control Hub. |
| 2 |
Acesse Notificações > Minhas regras. |
| 3 |
Clique em Criar regra. |
| 4 |
Na lista suspensa Serviço, selecione Chamada. 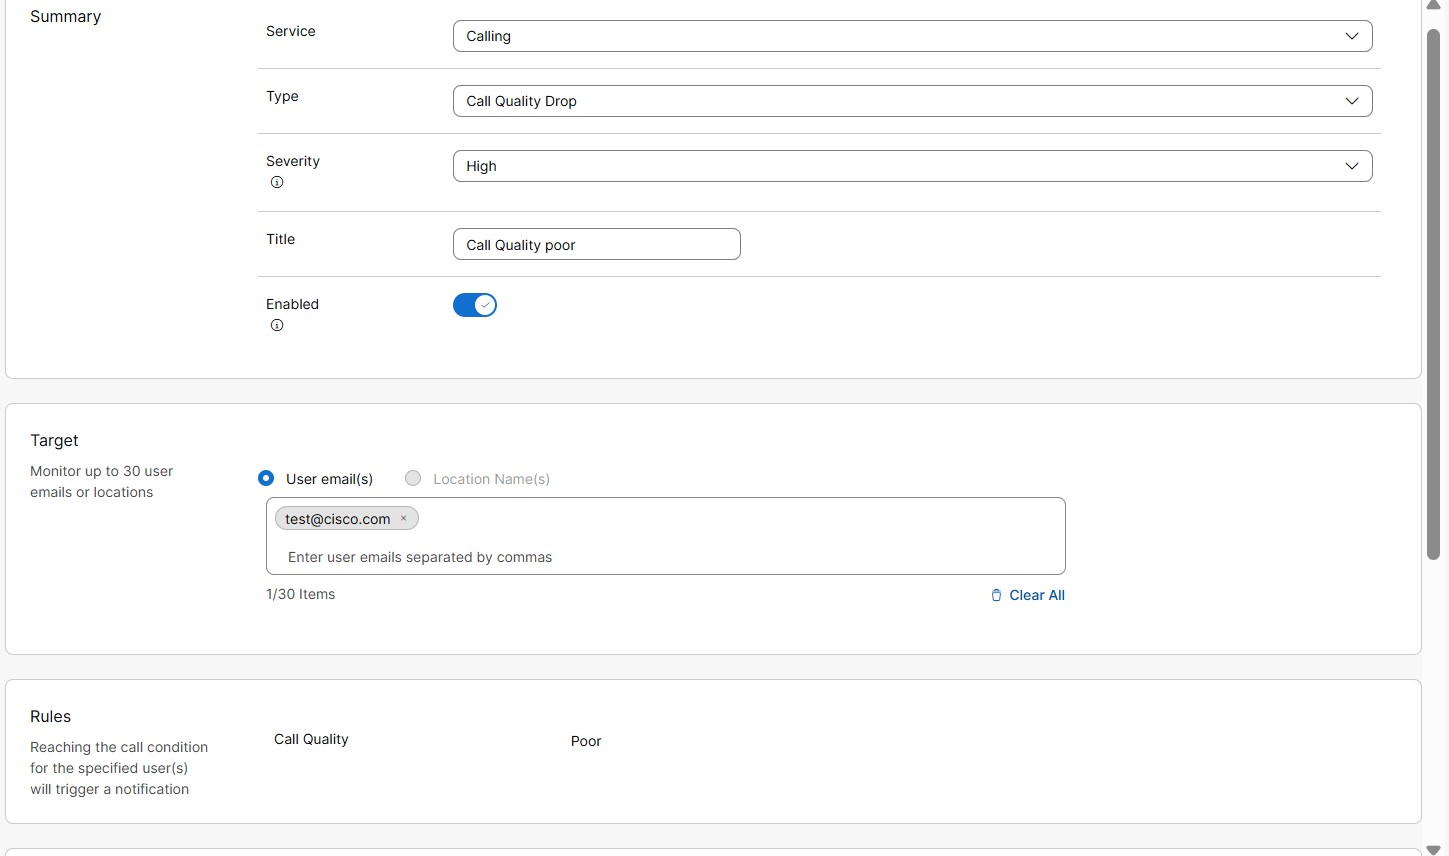
|
| 5 |
Na lista suspensa Tipo, selecione Queda na qualidade da chamada. |
| 6 |
Na lista suspensa Severidade. Esse campo mostra a gravidade ou a importância de um alerta. Você pode escolher o nível de severidade como
Alto, Médio ou Baixo.
|
| 7 |
Insira um título. |
| 8 |
Ative a opção Ativado para receber notificações do alerta. |
| 9 |
Na seção Destino, selecione E-mail (s) do usuário ou Nome (s) do local. Você pode inserir até 30 endereços de e-mail ou locais de usuário para monitorar.
|
| 10 |
Na seção Canal de entrega, escolha como receber os alertas: 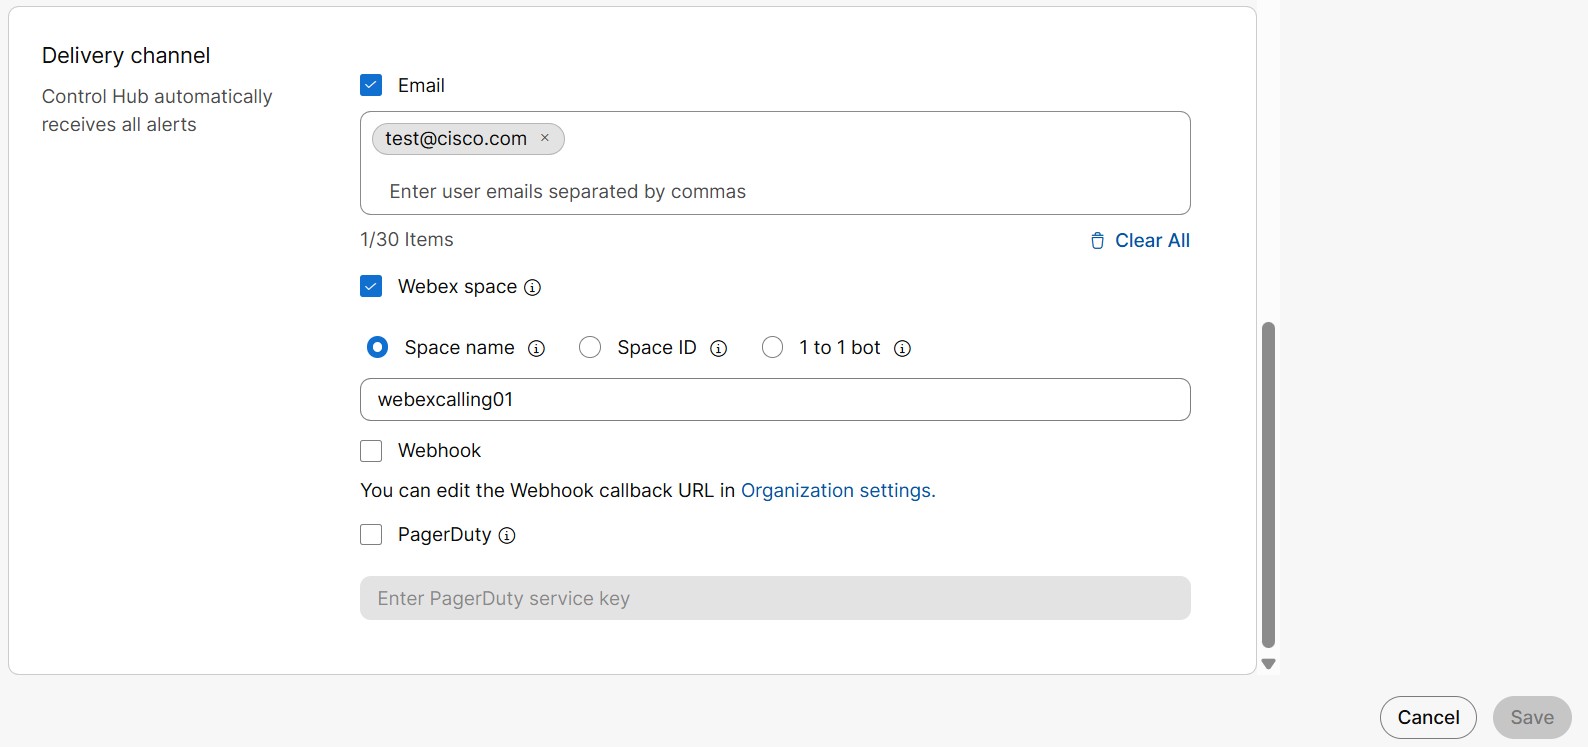
|
| 11 |
Clique em Salvar. |
Adicionar um alerta de alteração do status do tronco
Um alerta é enviado quando o status do tronco monitorado muda. Os status de tronco disponíveis são on-line, off-line e desativados. Você pode configurar qual alteração de status deve acionar um alerta.
A seguir estão os diferentes status do tronco:
-
Online — Registro bem-sucedido do Local Gateway paraWebex Calling.
-
Off-line — Registro malsucedido do gateway local no. Webex Calling
-
Deficiente — Conexão malsucedida entre pelo menos um proxy Webex Calling Edge e o gateway local.
-
Desconhecido — No processo de estabelecer uma conexão entre Webex Calling e o gateway local que foi adicionado recentemente.
Para saber mais sobre várias alterações de erro de status, consulte o artigo da Central de Ajuda, seção Solução de problemas de gateway local.
| 1 |
Faça login no Control Hub. |
| 2 |
Acesse Notificações > Minhas regras. |
| 3 |
Clique em Criar regra. |
| 4 |
Na lista suspensa Serviço, selecione Chamada. 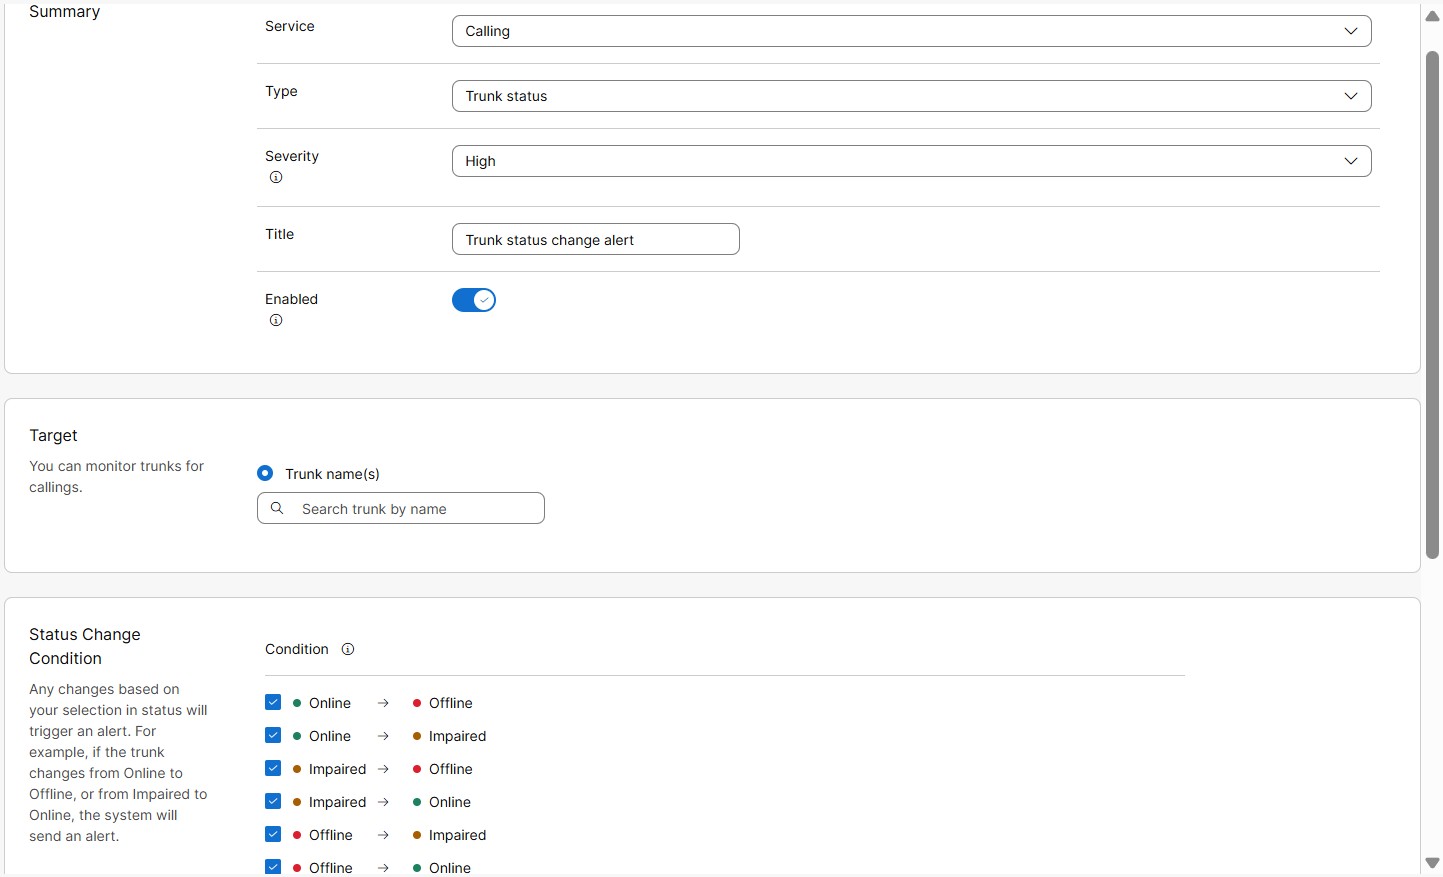
|
| 5 |
Na lista suspensa Tipo, selecione Status do tronco . |
| 6 |
Na lista suspensa Severidade. Esse campo mostra a gravidade ou a importância de um alerta. Você pode escolher o nível de severidade como
Alto, Médio ou Baixo.
|
| 7 |
Insira um título. |
| 8 |
Ative Ativado para receber notificações do alerta |
| 9 |
Na seção Destino, selecione Nome (s) do tronco. Você pode inserir até 30 troncos para monitorar.
Os alertas não são acionados em troncos baseados em Instância Dedicada (DI). |
| 10 |
Na seção Definição de regra, você pode definir a regra para quando o alerta precisa ser acionado. Você pode selecionar tudo ou escolher entre as seguintes alterações de status:
|
| 11 |
Na seção Canal de entrega, escolha como receber os alertas:
|
| 12 |
Clique em Salvar. |
Adicionar um alerta de limite de chamadas simultâneas de tronco
Um alerta é enviado quando o limite limite de chamadas simultâneas no tronco é atingido. Esse alerta ajuda a identificar a hora ou o dia de pico em que a capacidade do tronco é atingida para lidar com chamadas simultâneas.
Os alertas consecutivos são acionados no intervalo de tempo selecionado, se o limite configurado continuar sendo violado.
| 1 |
Faça login no Control Hub. |
| 2 |
Acesse Notificações > Minhas regras. |
| 3 |
Clique em Criar regra. |
| 4 |
Na lista suspensa Serviço, selecione Chamada. 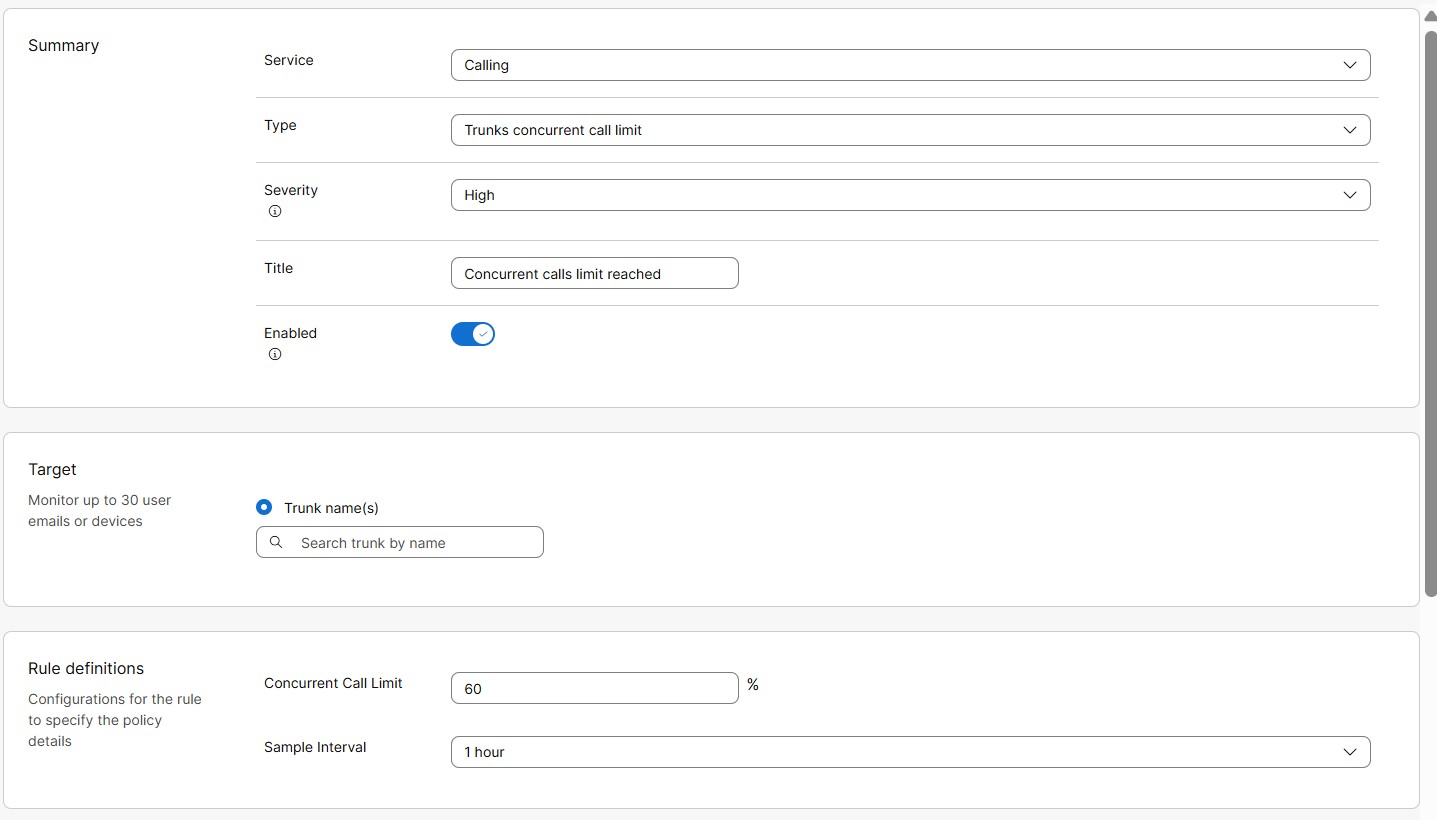
|
| 5 |
Na lista suspensa Tipo, selecione Limite de chamadas simultâneas de tronco. |
| 6 |
Na lista suspensa Severidade. Esse campo mostra a gravidade ou a importância de um alerta. Você pode escolher o nível de severidade como
Alto, Médio ou Baixo.
|
| 7 |
Insira um título. |
| 8 |
Ative a opção Ativado para receber notificações do alerta. |
| 9 |
Na seção Destino, selecione Nome (s) do tronco. Você pode inserir até 30 troncos para monitorar.
Os alertas não são acionados em troncos baseados em Instância Dedicada (DI). |
| 10 |
Na seção Definições de regras, você pode definir a regra para quando o alerta precisa ser acionado. Insira os seguintes valores para a condição de limite de chamadas simultâneas: |
| 11 |
Na seção Canal de entrega, escolha como receber os alertas:
|
| 12 |
Clique em Salvar. |
Alerta de expiração do certificado de tronco
Um alerta é enviado quando o certificado de um tronco baseado em certificado está prestes a expirar ou já expirou. Esse é um alerta gerado pelo sistema, ativado por padrão para organizações com troncos baseados em certificados.
Antes da expiração do certificado, os alertas automáticos são enviados em dias predefinidos, como no 60º dia, 30º dia, 15º dia e 7º dia antes da expiração. Depois que o certificado expirar, um alerta é enviado imediatamente e somente uma vez. Nenhum alerta consecutivo é enviado.
Os alertas não são acionados em troncos baseados em Instância Dedicada (DI).
Alerta de bloqueio de chamadas da lista de rotas
Quando o número de chamadas simultâneas excede o limite da licença Route List Calls, até 20% de capacidade adicional (intermitente) é permitida. Quando o volume de chamadas fora da rede (PSTN) excede os limites de intermitência de 20%, elas são bloqueadas. Um alerta é enviado ao usuário sobre o bloqueio das chamadas da Lista de Rotas.
Antes de começar
| 1 |
Faça login no Control Hub. |
| 2 |
Vá até Notificações > Todas as regras. A lista de todas as regras é exibida.
|
| 3 |
Selecione Lista de rotas > Chamadas bloqueadas > alerta. O alerta Route List Calls Blocked é um alerta gerado pelo sistema. Portanto, você só pode editar alguns de seus detalhes, conforme mencionado nas próximas etapas. 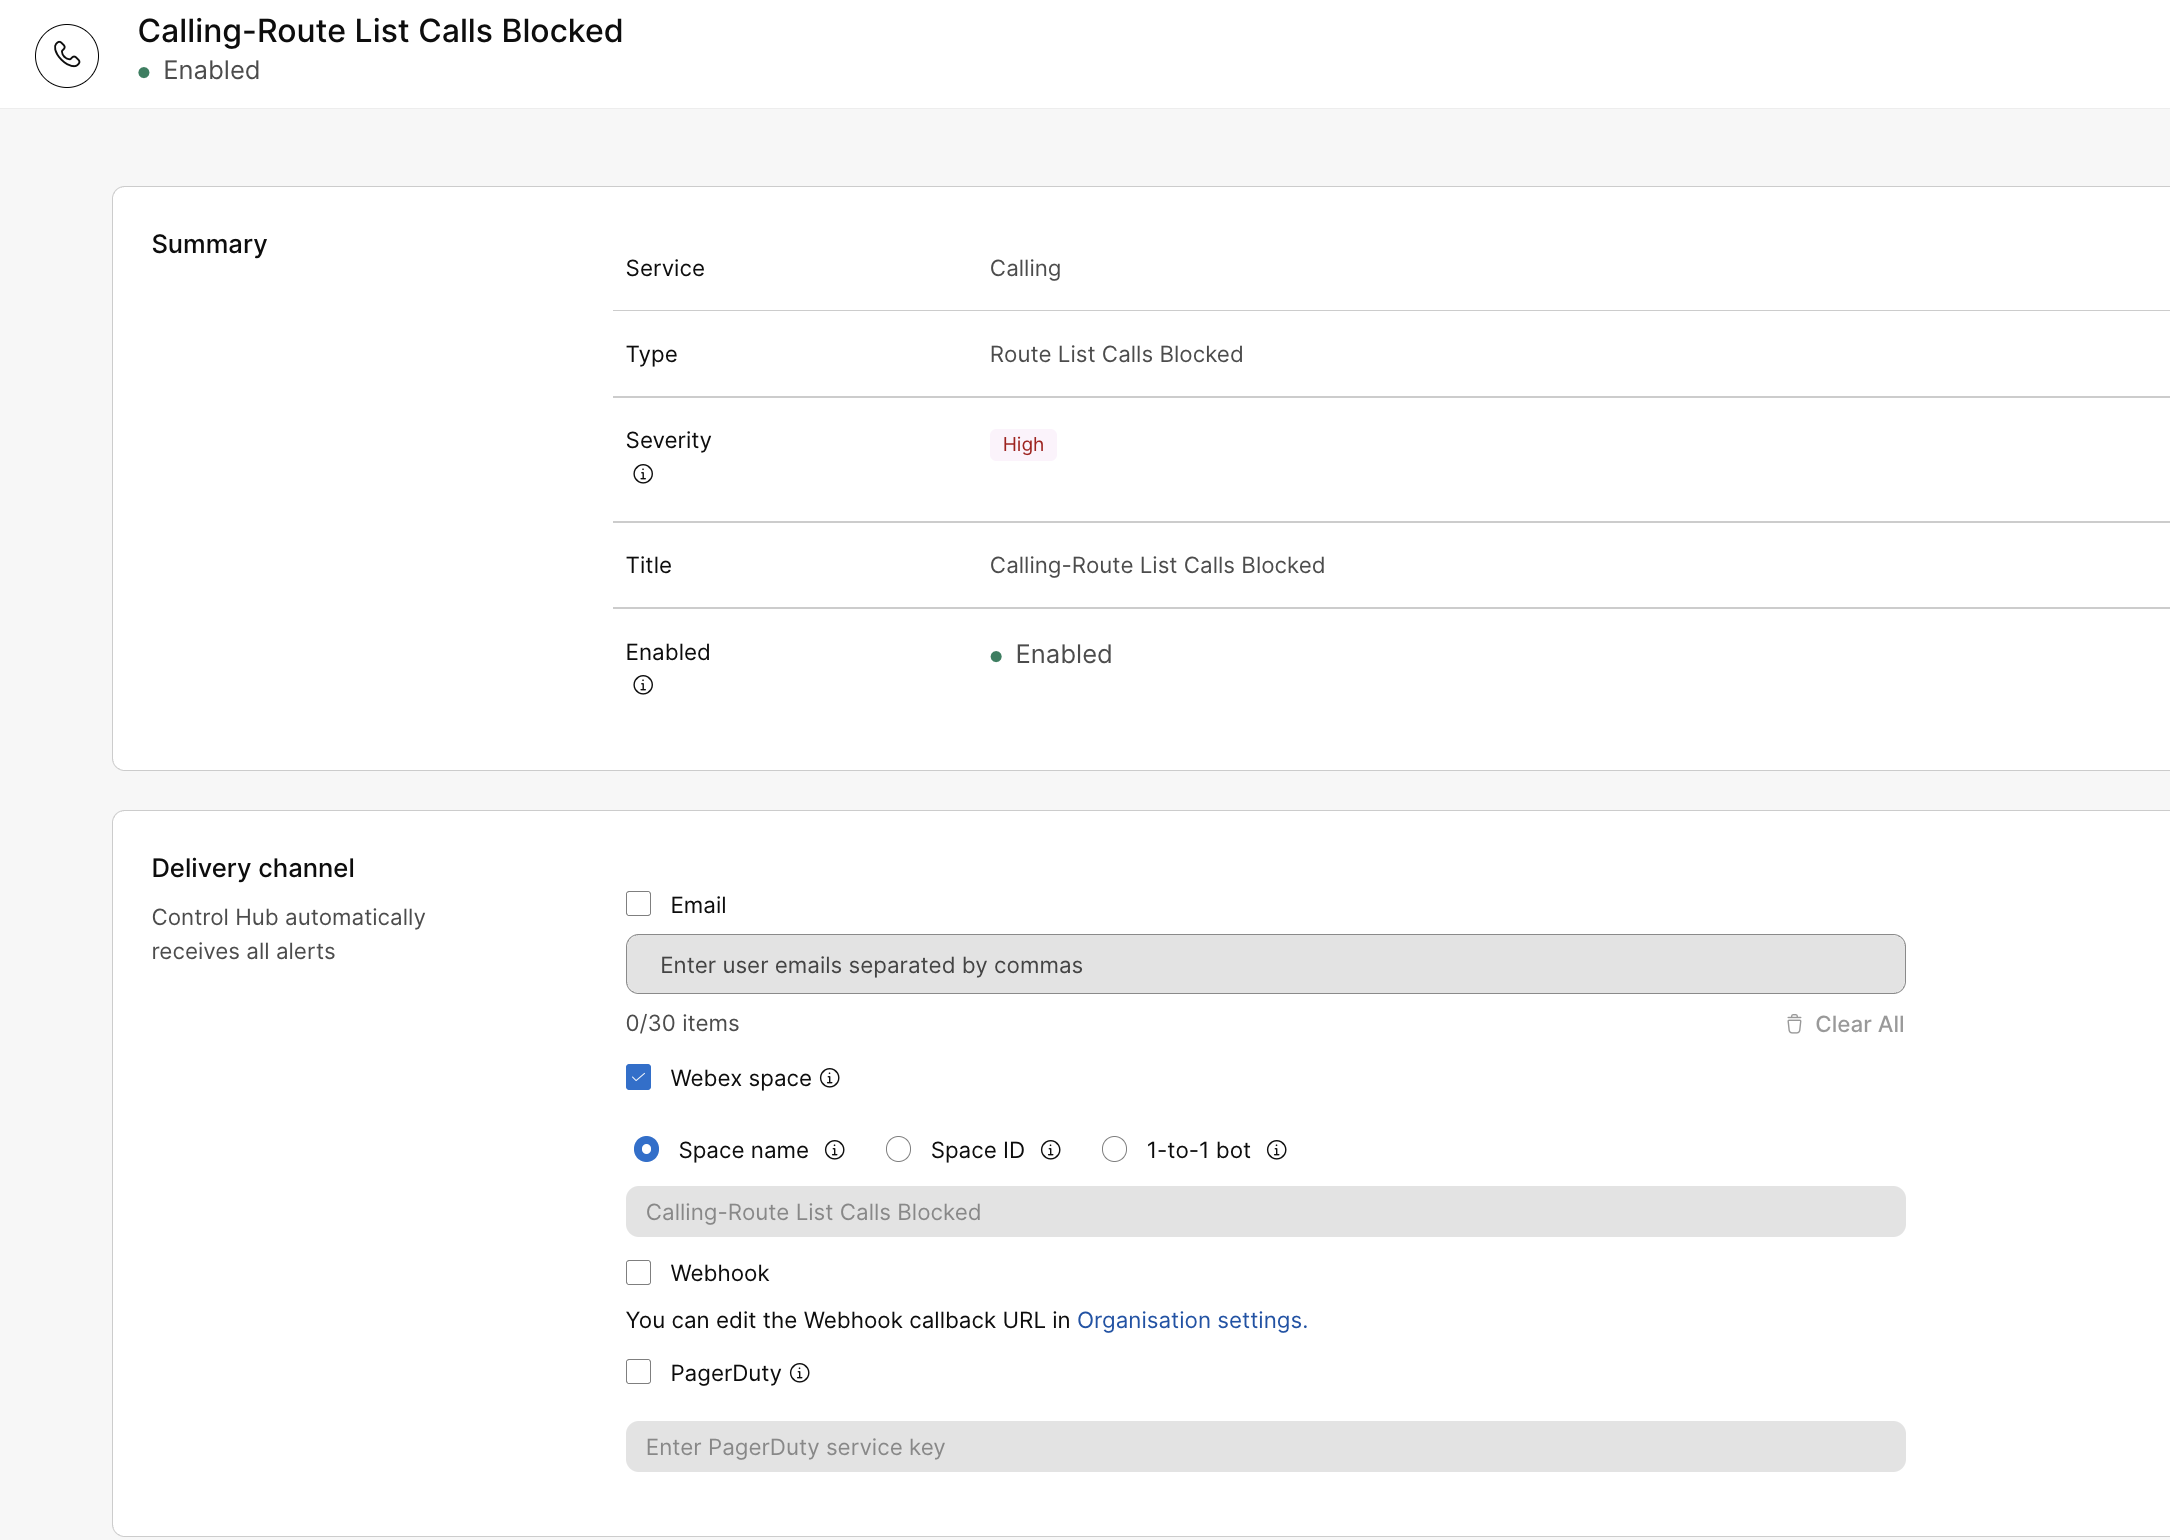
|
| 4 |
Na seção Canal de entrega, escolha como receber os alertas:
|
| 5 |
Clique em Salvar. |
Há duas categorias de alertas de serviço para instâncias dedicadas: alertas de manutenção e alertas proativos.
Alertas de manutenção
O sistema ativa alertas de manutenção por padrão. Os administradores do parceiro ou do cliente devem verificar ou configurar o canal de entrega para receber notificações por e-mail e/ou espaço Webex . Os alertas de manutenção são usados para enviar notificações sobre manutenção, interrupções e comunicação de incidentes.
Para adicionar informações do canal de entrega para receber alertas de manutenção:
- Entre no Control Hub e acesse Notificações > Todas as regras.
- Clique em Chamadas-Manutenção e Alertas de Interrupção e role para baixo até Canal de Entrega.
- Marque uma ou ambas as caixas de seleção Email ou Webex Spaces para receber a notificação no canal preferido.
Você pode adicionar até 30 IDs de e-mail.
Para receber notificações em um espaço Webex, você deve ter uma licença de mensagens. Se o acesso ao bot estiver ativado em Aplicativos/Bots e você tiver permissão para ser membro da sala da organização, você receberá as notificações. Caso contrário, entre em contato com o administrador da organização para resolver o problema.
Você pode selecionar Webhooks se tiver Webhooks habilitados no nível organizacional. Para obter mais informações, consulte Habilitar webhooks para alertas no Control Hub.
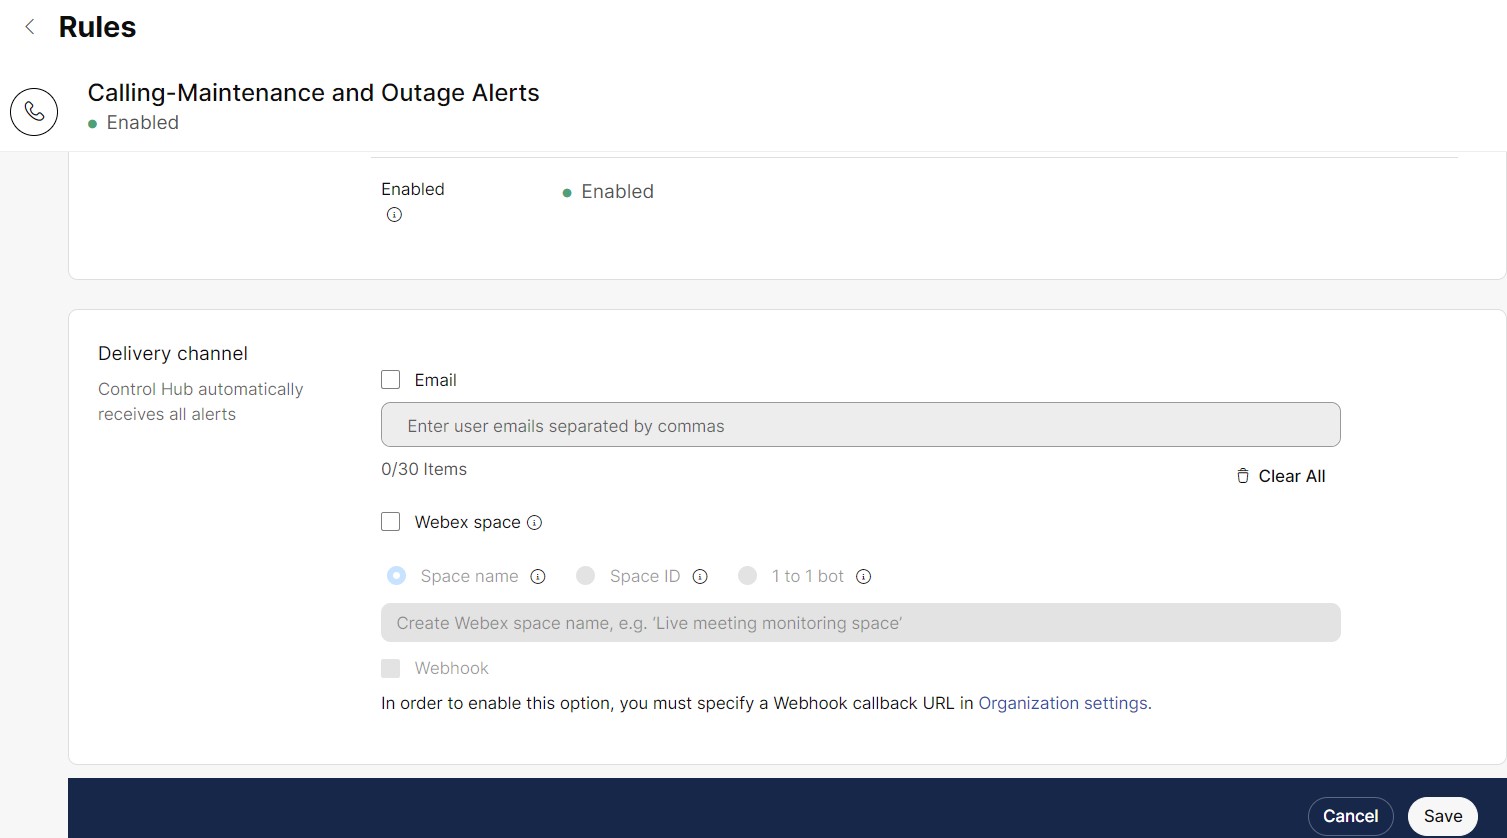
- Insira as informações de e-mail e espaço Webex e clique em Salvar para salvar as alterações.
Sempre que a manutenção ocorre, o Control Hub exibe automaticamente um banner com os detalhes do cluster, a região e a data e a hora programadas.

Alertas proativos
Os administradores de parceiros ou clientes podem assinar alertas proativos e notificações de eventos do segundo ou terceiro dia e optar por recebê-los por e-mail, espaços do aplicativo Webex ou ambos selecionando o canal de entrega ao criar o alerta.
Por exemplo: Unified CM Video Conf Bridge Out of Resource Count High, Unified CM MTP Out of Resource Count High.
Para criar uma regra de alerta proativa
Somente o administrador do parceiro ou do cliente com direitos administrativos totais pode criar regras.
- Entre no Control Hub e acesse Notificações > Minhas regras.
- Selecione Criar regra.
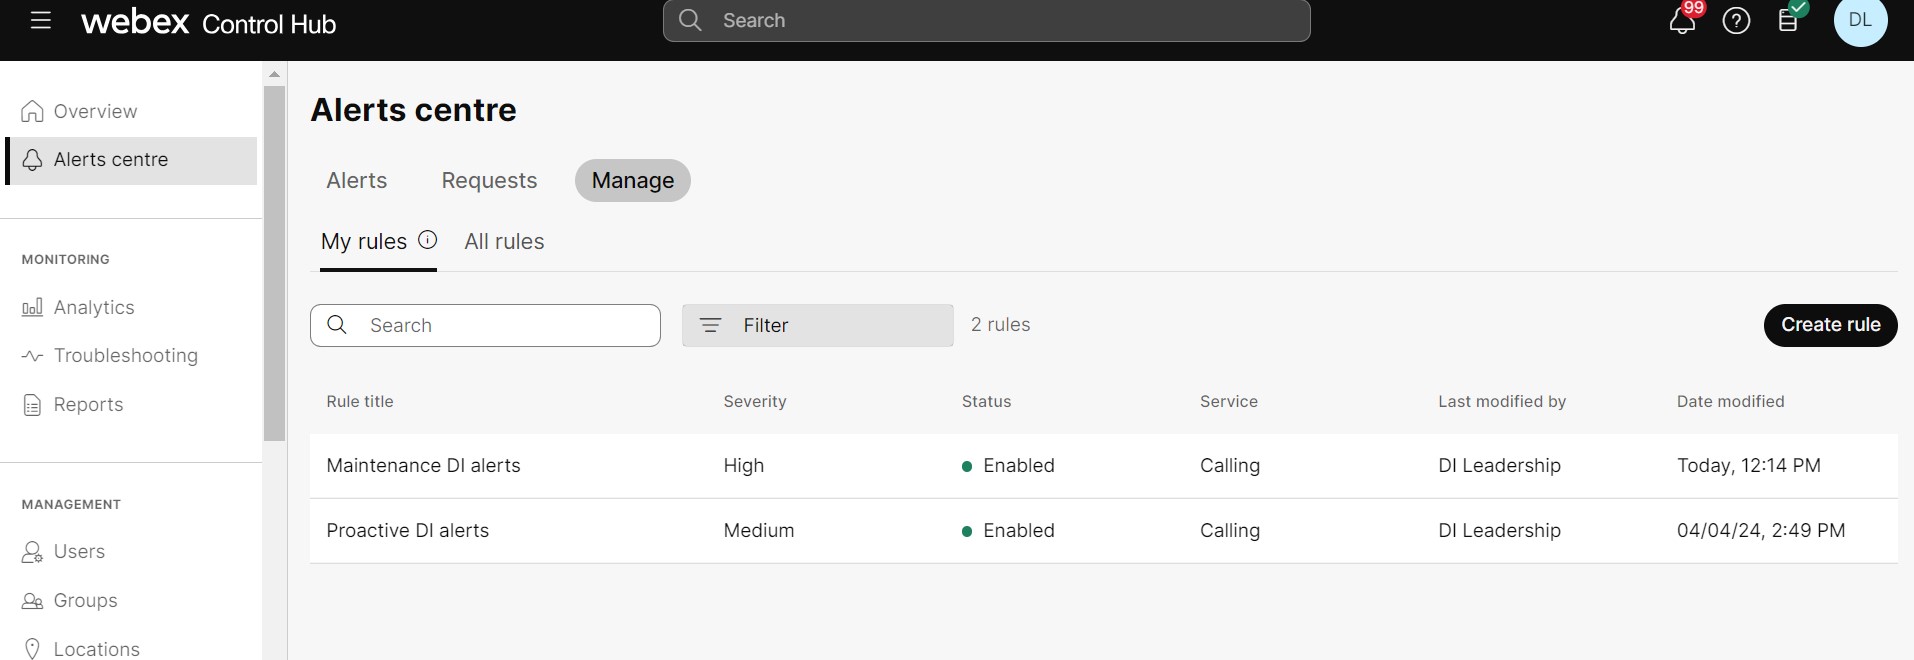
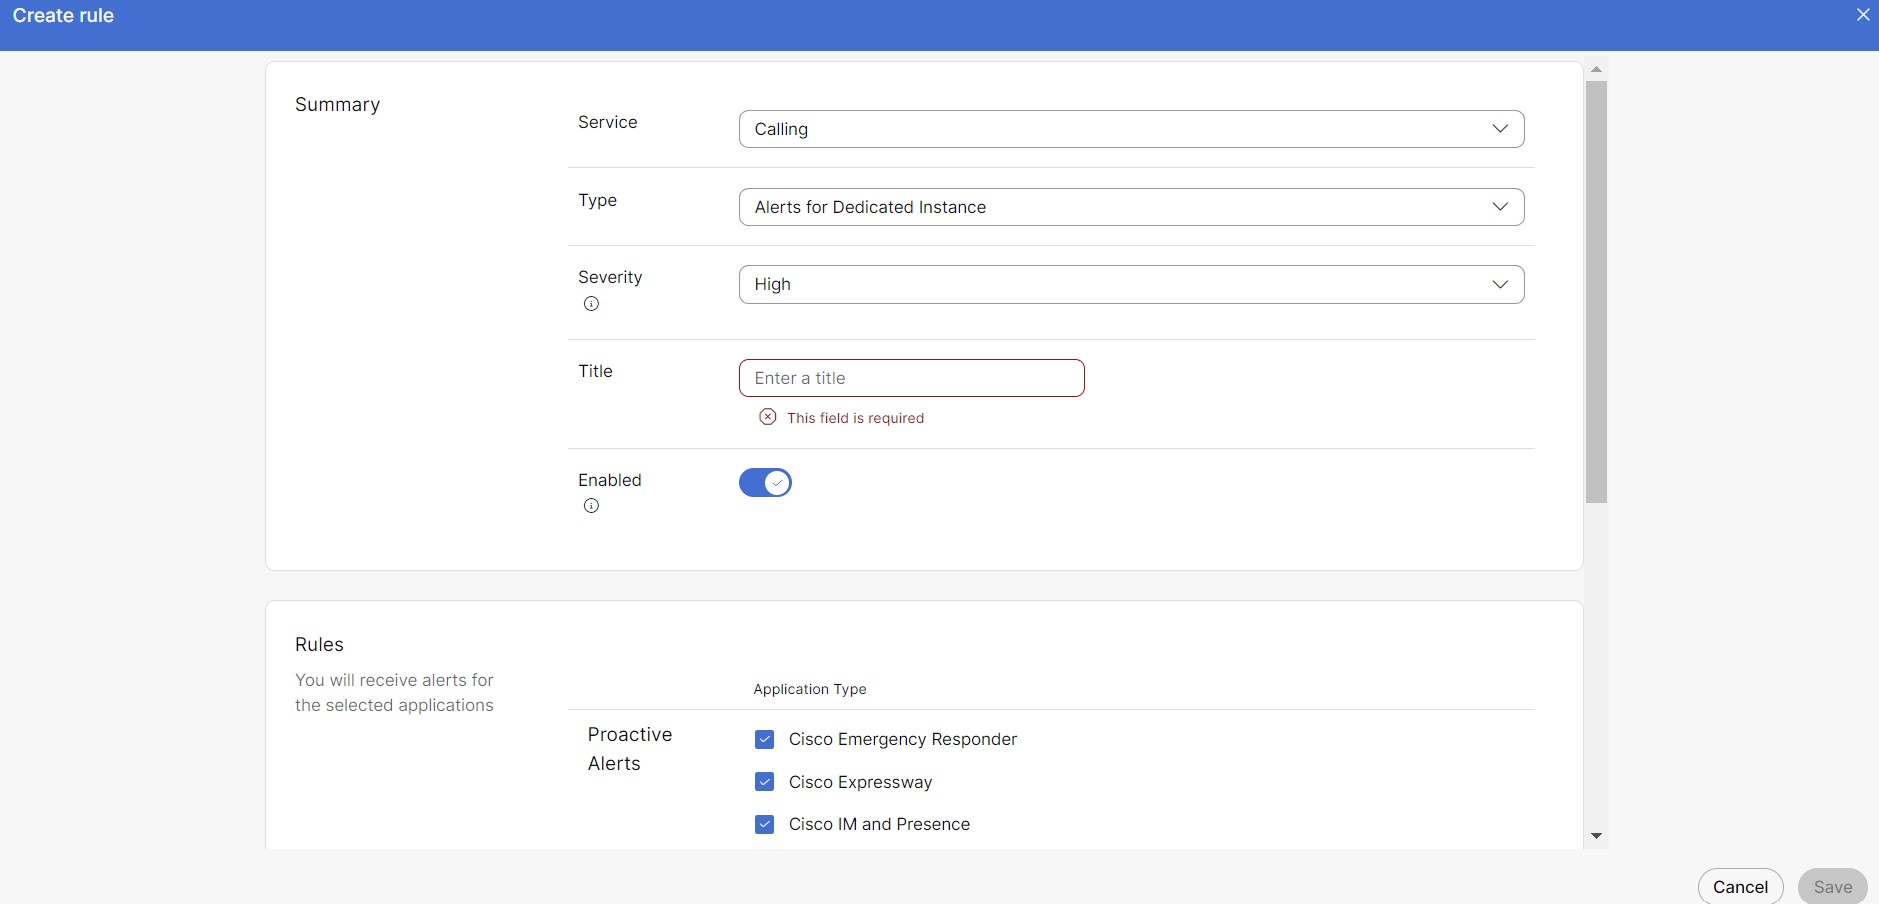
- Na seção Resumo:
- Selecione Chamada na lista suspensa Serviço.
- Selecione Alertas para instância dedicada na lista suspensa Tipo.
- Selecione a severidade preferida. Por padrão, a severidade é Alta.
-
Recomendamos criar regras para alertas proativos com severidade média ou baixa.
-
Você recebe alertas que correspondem ou excedem o nível de severidade selecionado ao configurar a regra.
-
- Adicione um título para a nova regra.
- Todas as caixas de seleção na seção Regras são selecionadas por padrão. Desmarque aqueles com base em suas preferências.
- Selecione o canal de entrega para receber o alerta.
Você pode selecionar Webhooks se tiver Webhooks habilitados no nível organizacional. Para obter mais informações, consulte Habilitar webhooks para alertas no Control Hub.
- Clique em Salvar.
Depois que as regras são criadas, são necessárias no máximo 6 horas para começar a receber as notificações.
Status do alerta e suas legendas
O Control Hub consolida os status de vários serviços de aplicativos de UC, os status dos agentes e o status de manutenção de cada nó.
O status dos serviços de cada nó é atualizado a cada 30 segundos.
|
Alertas críticos |
|
|
|
|
Alertas não críticos |
|
|
Todos os outros serviços de UC que não estão listados acima são considerados serviços não críticos . |
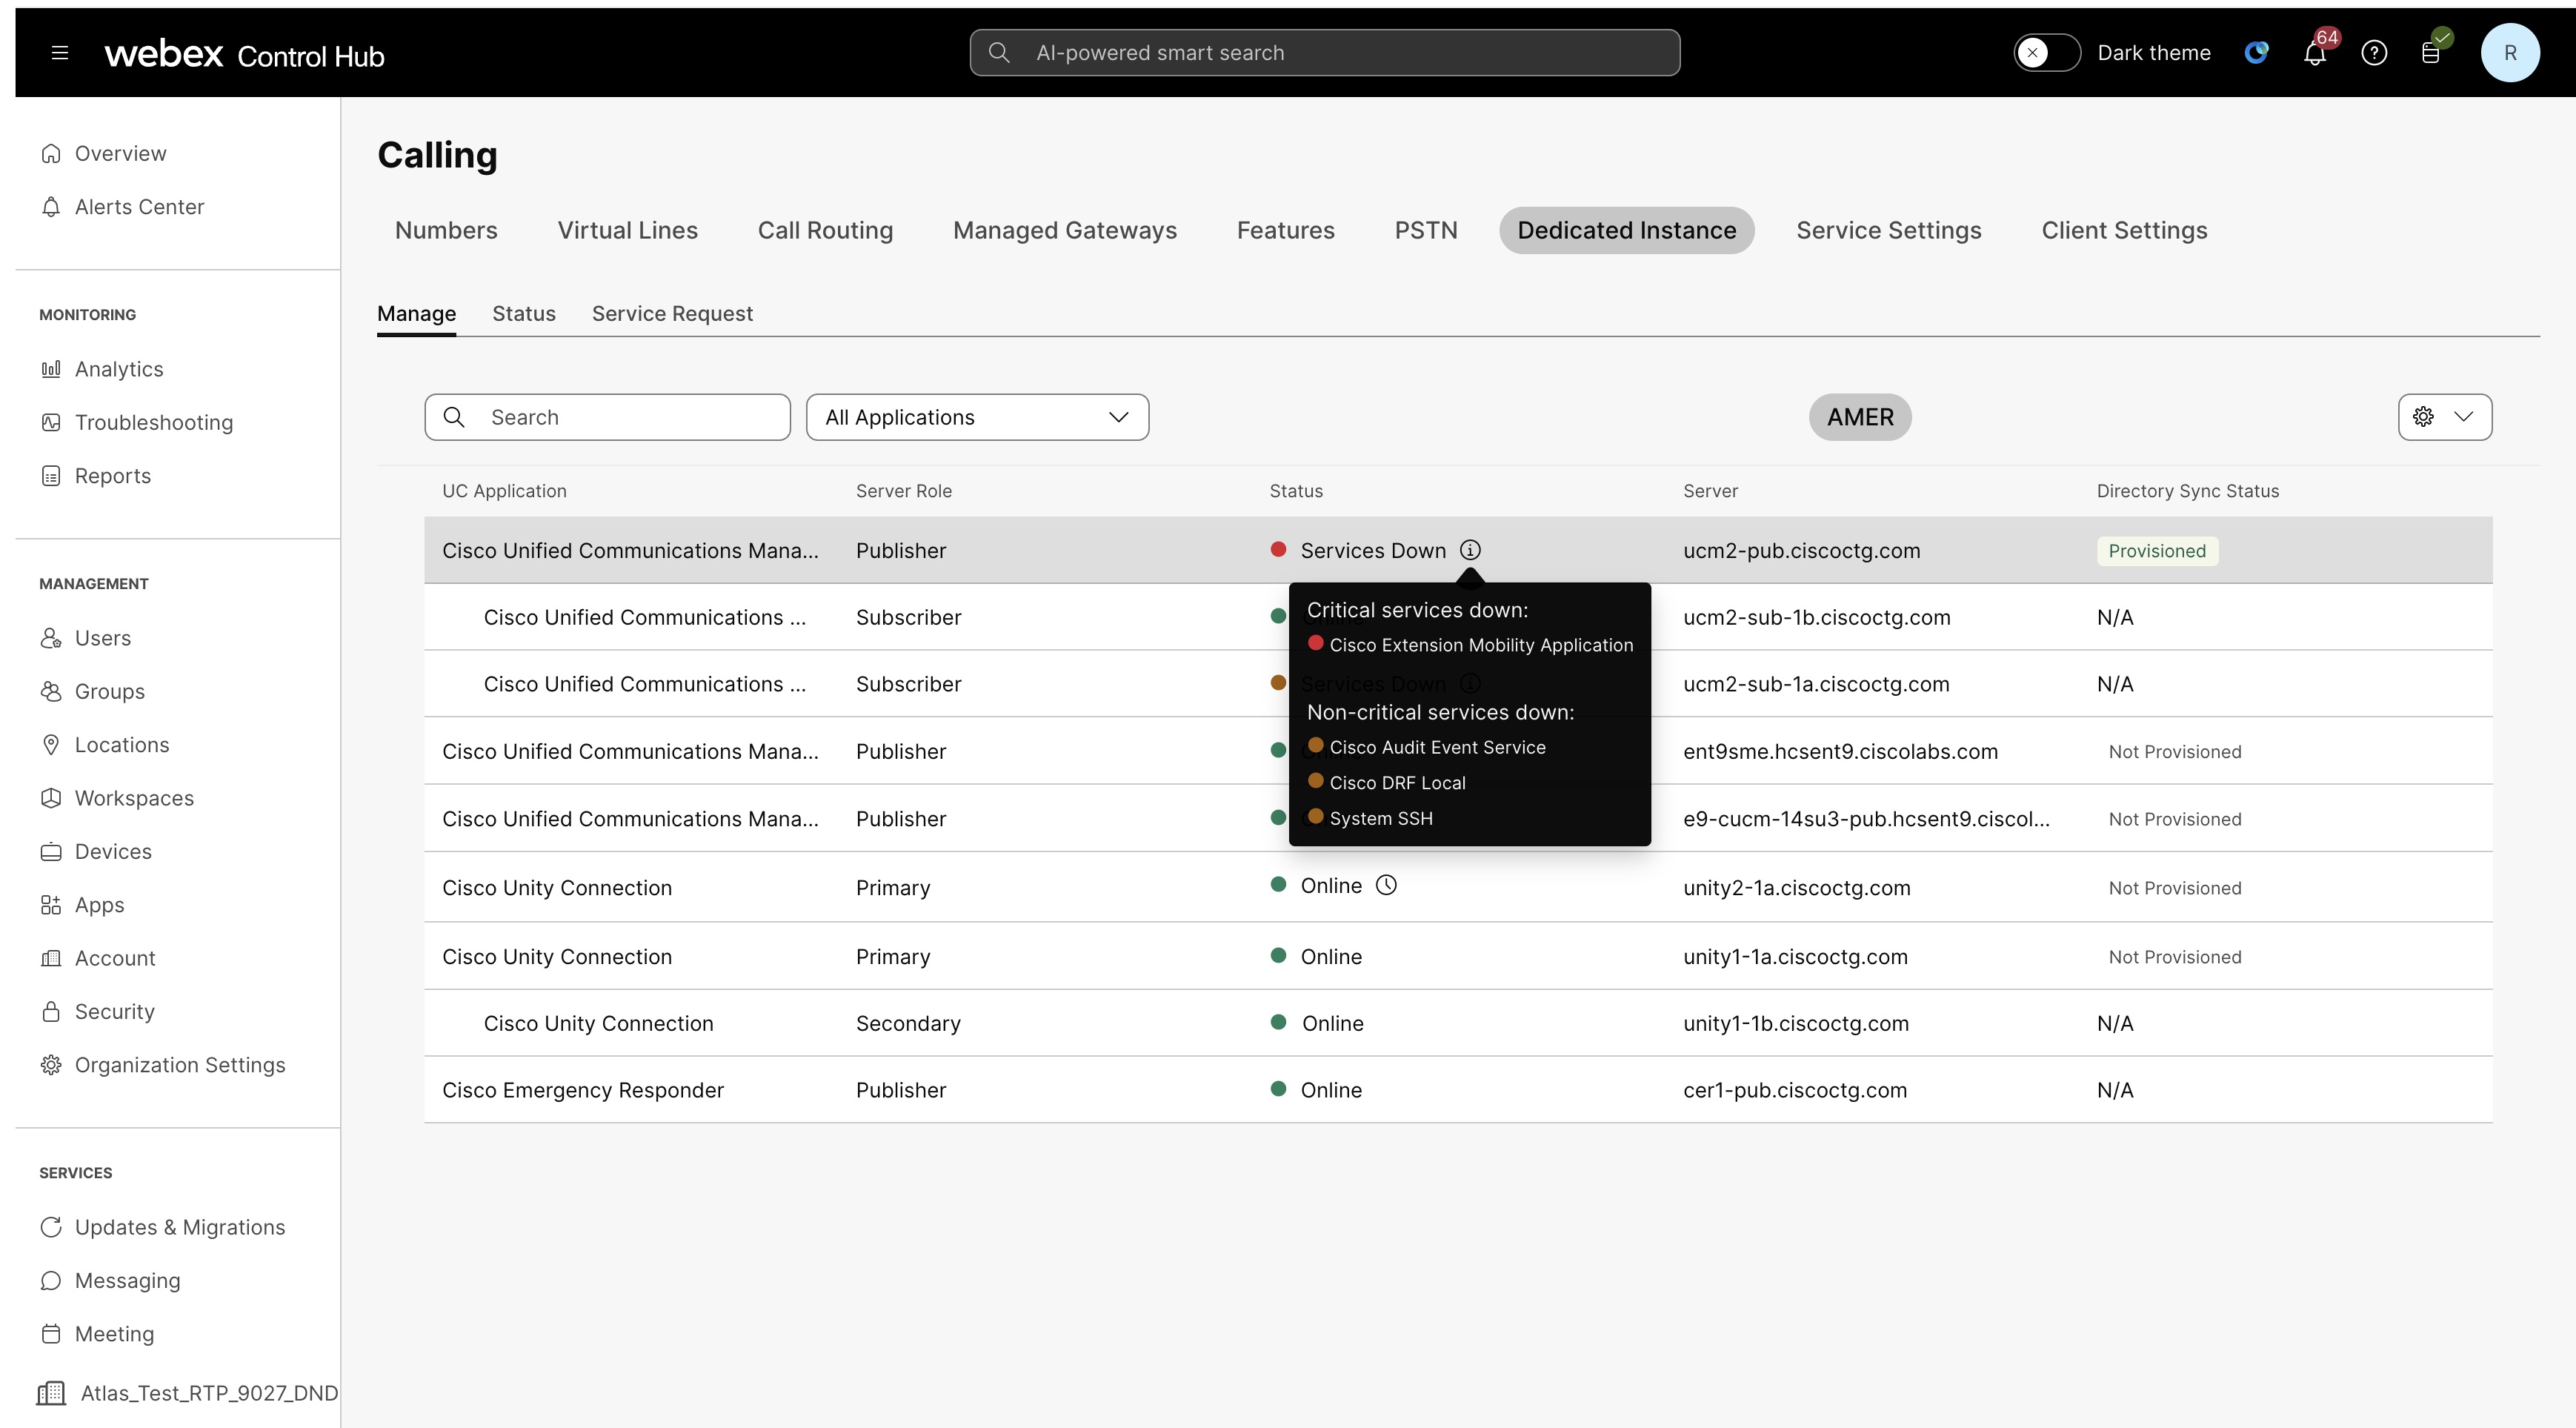
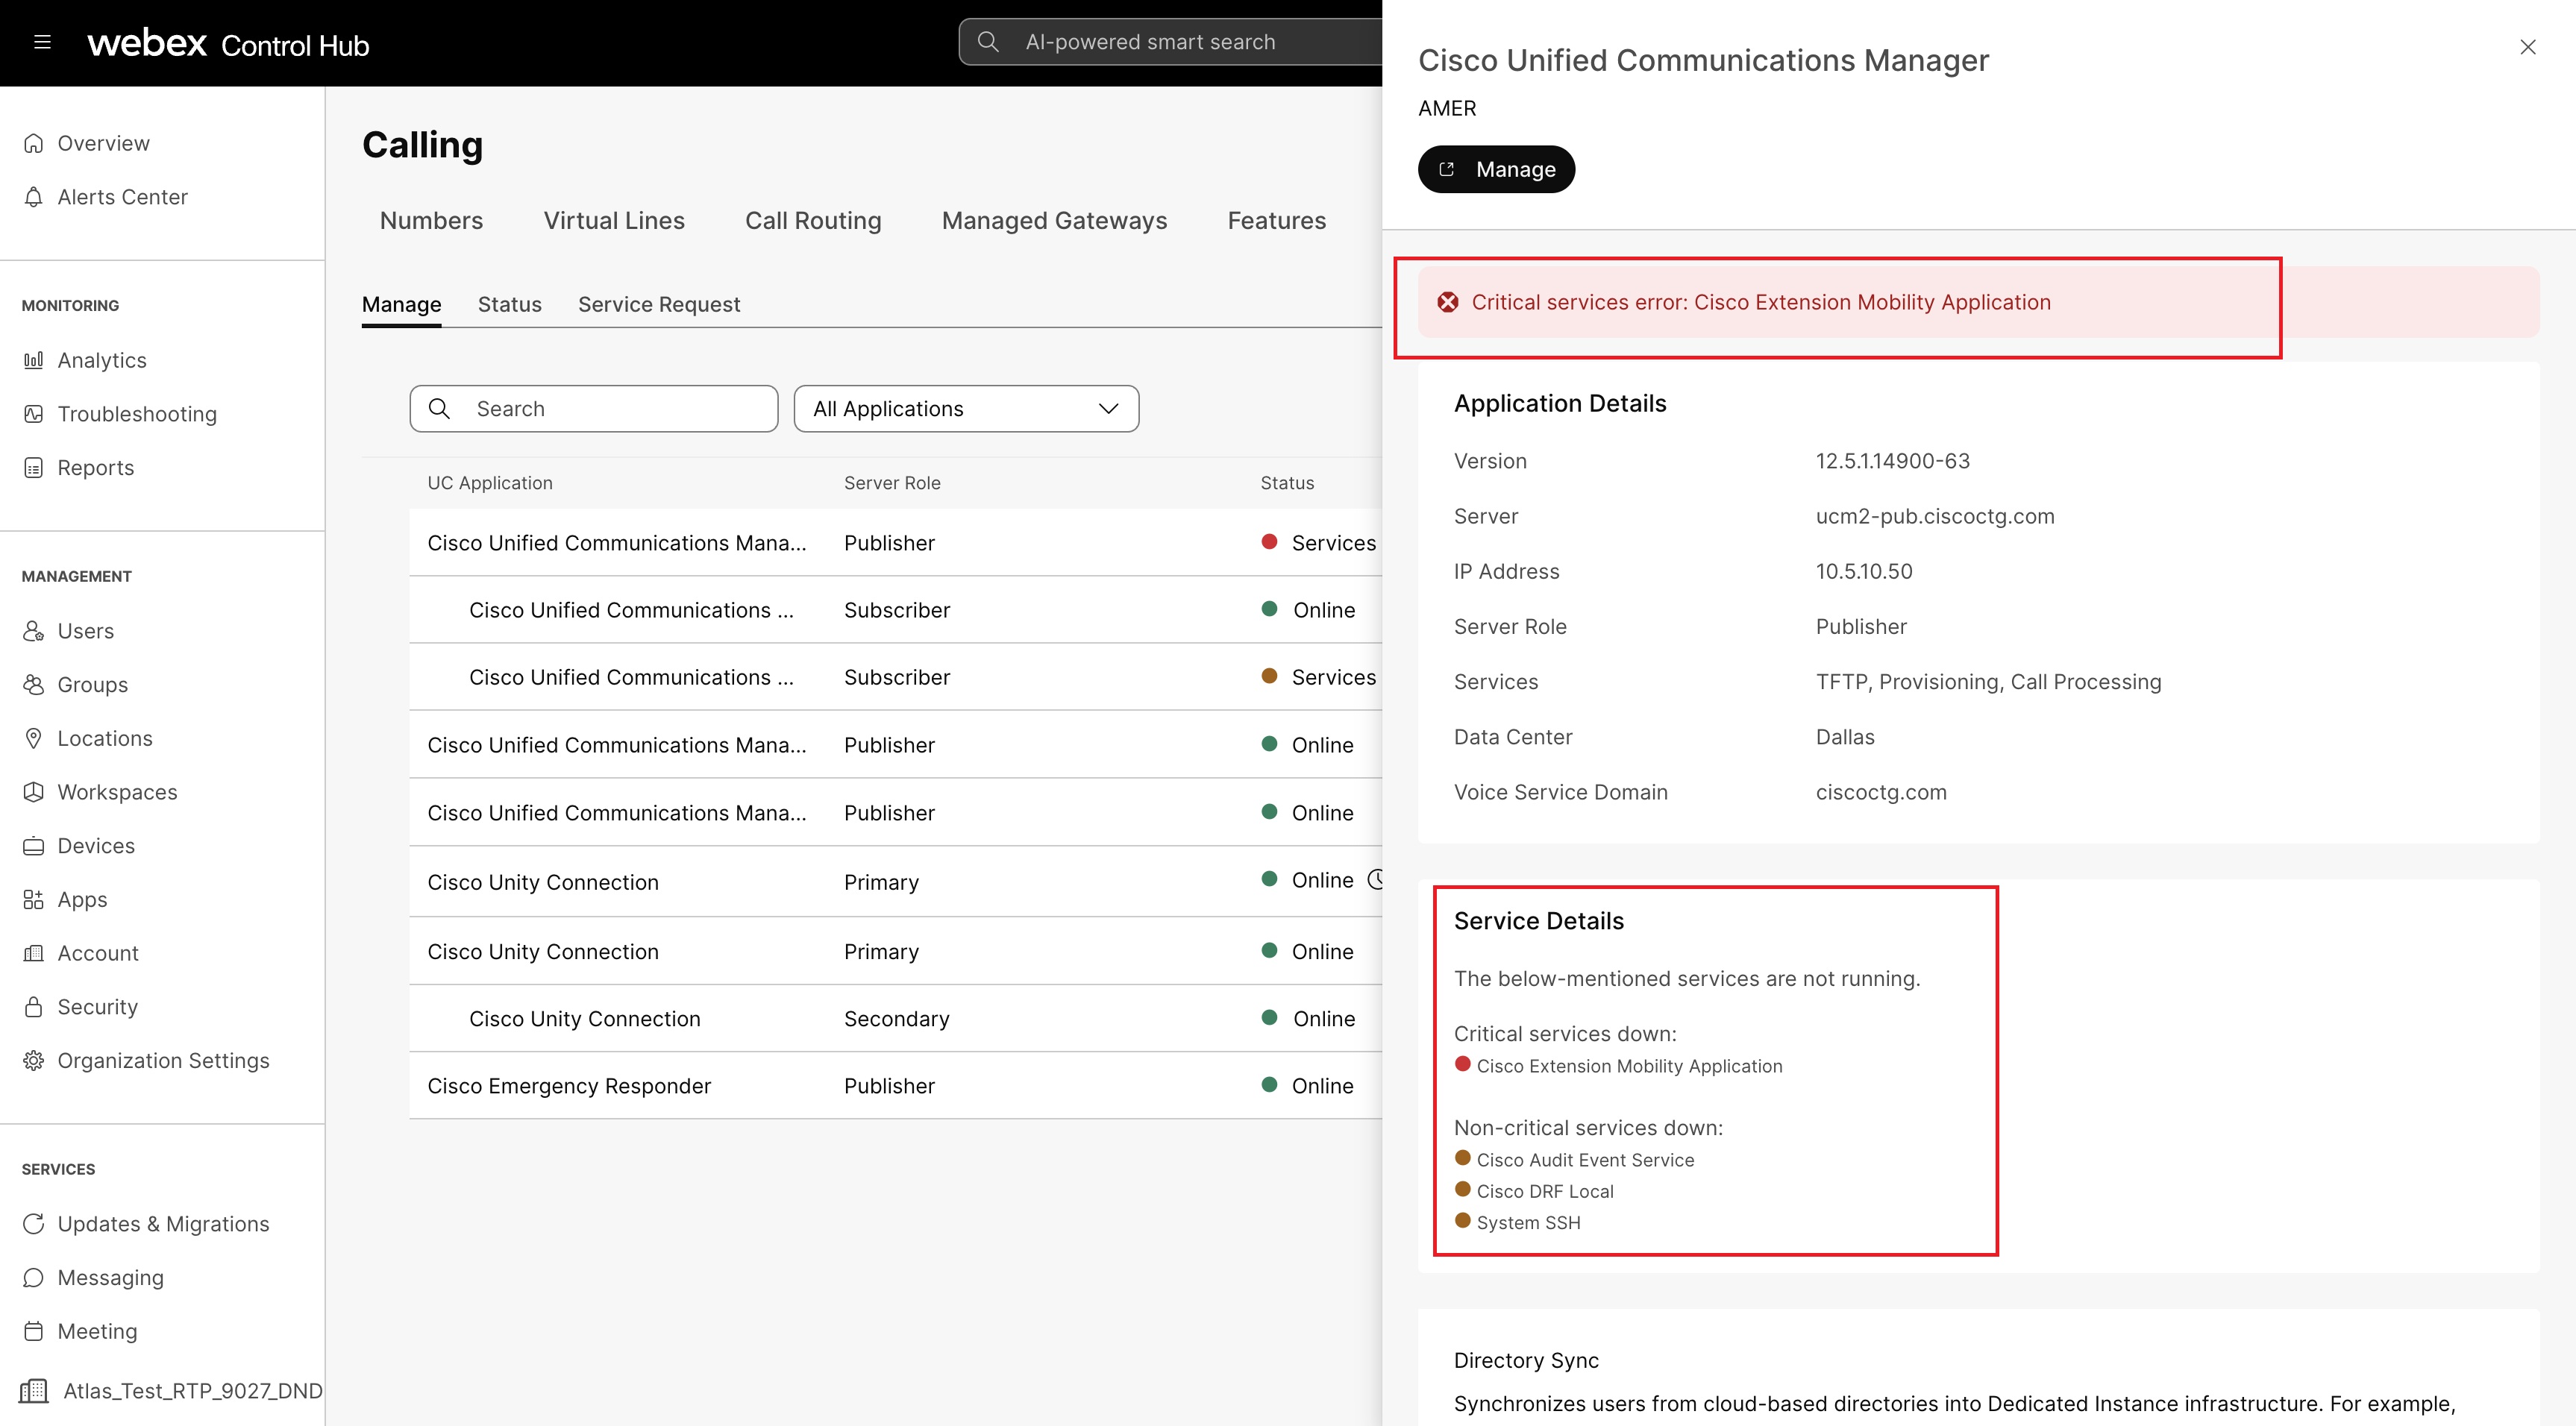
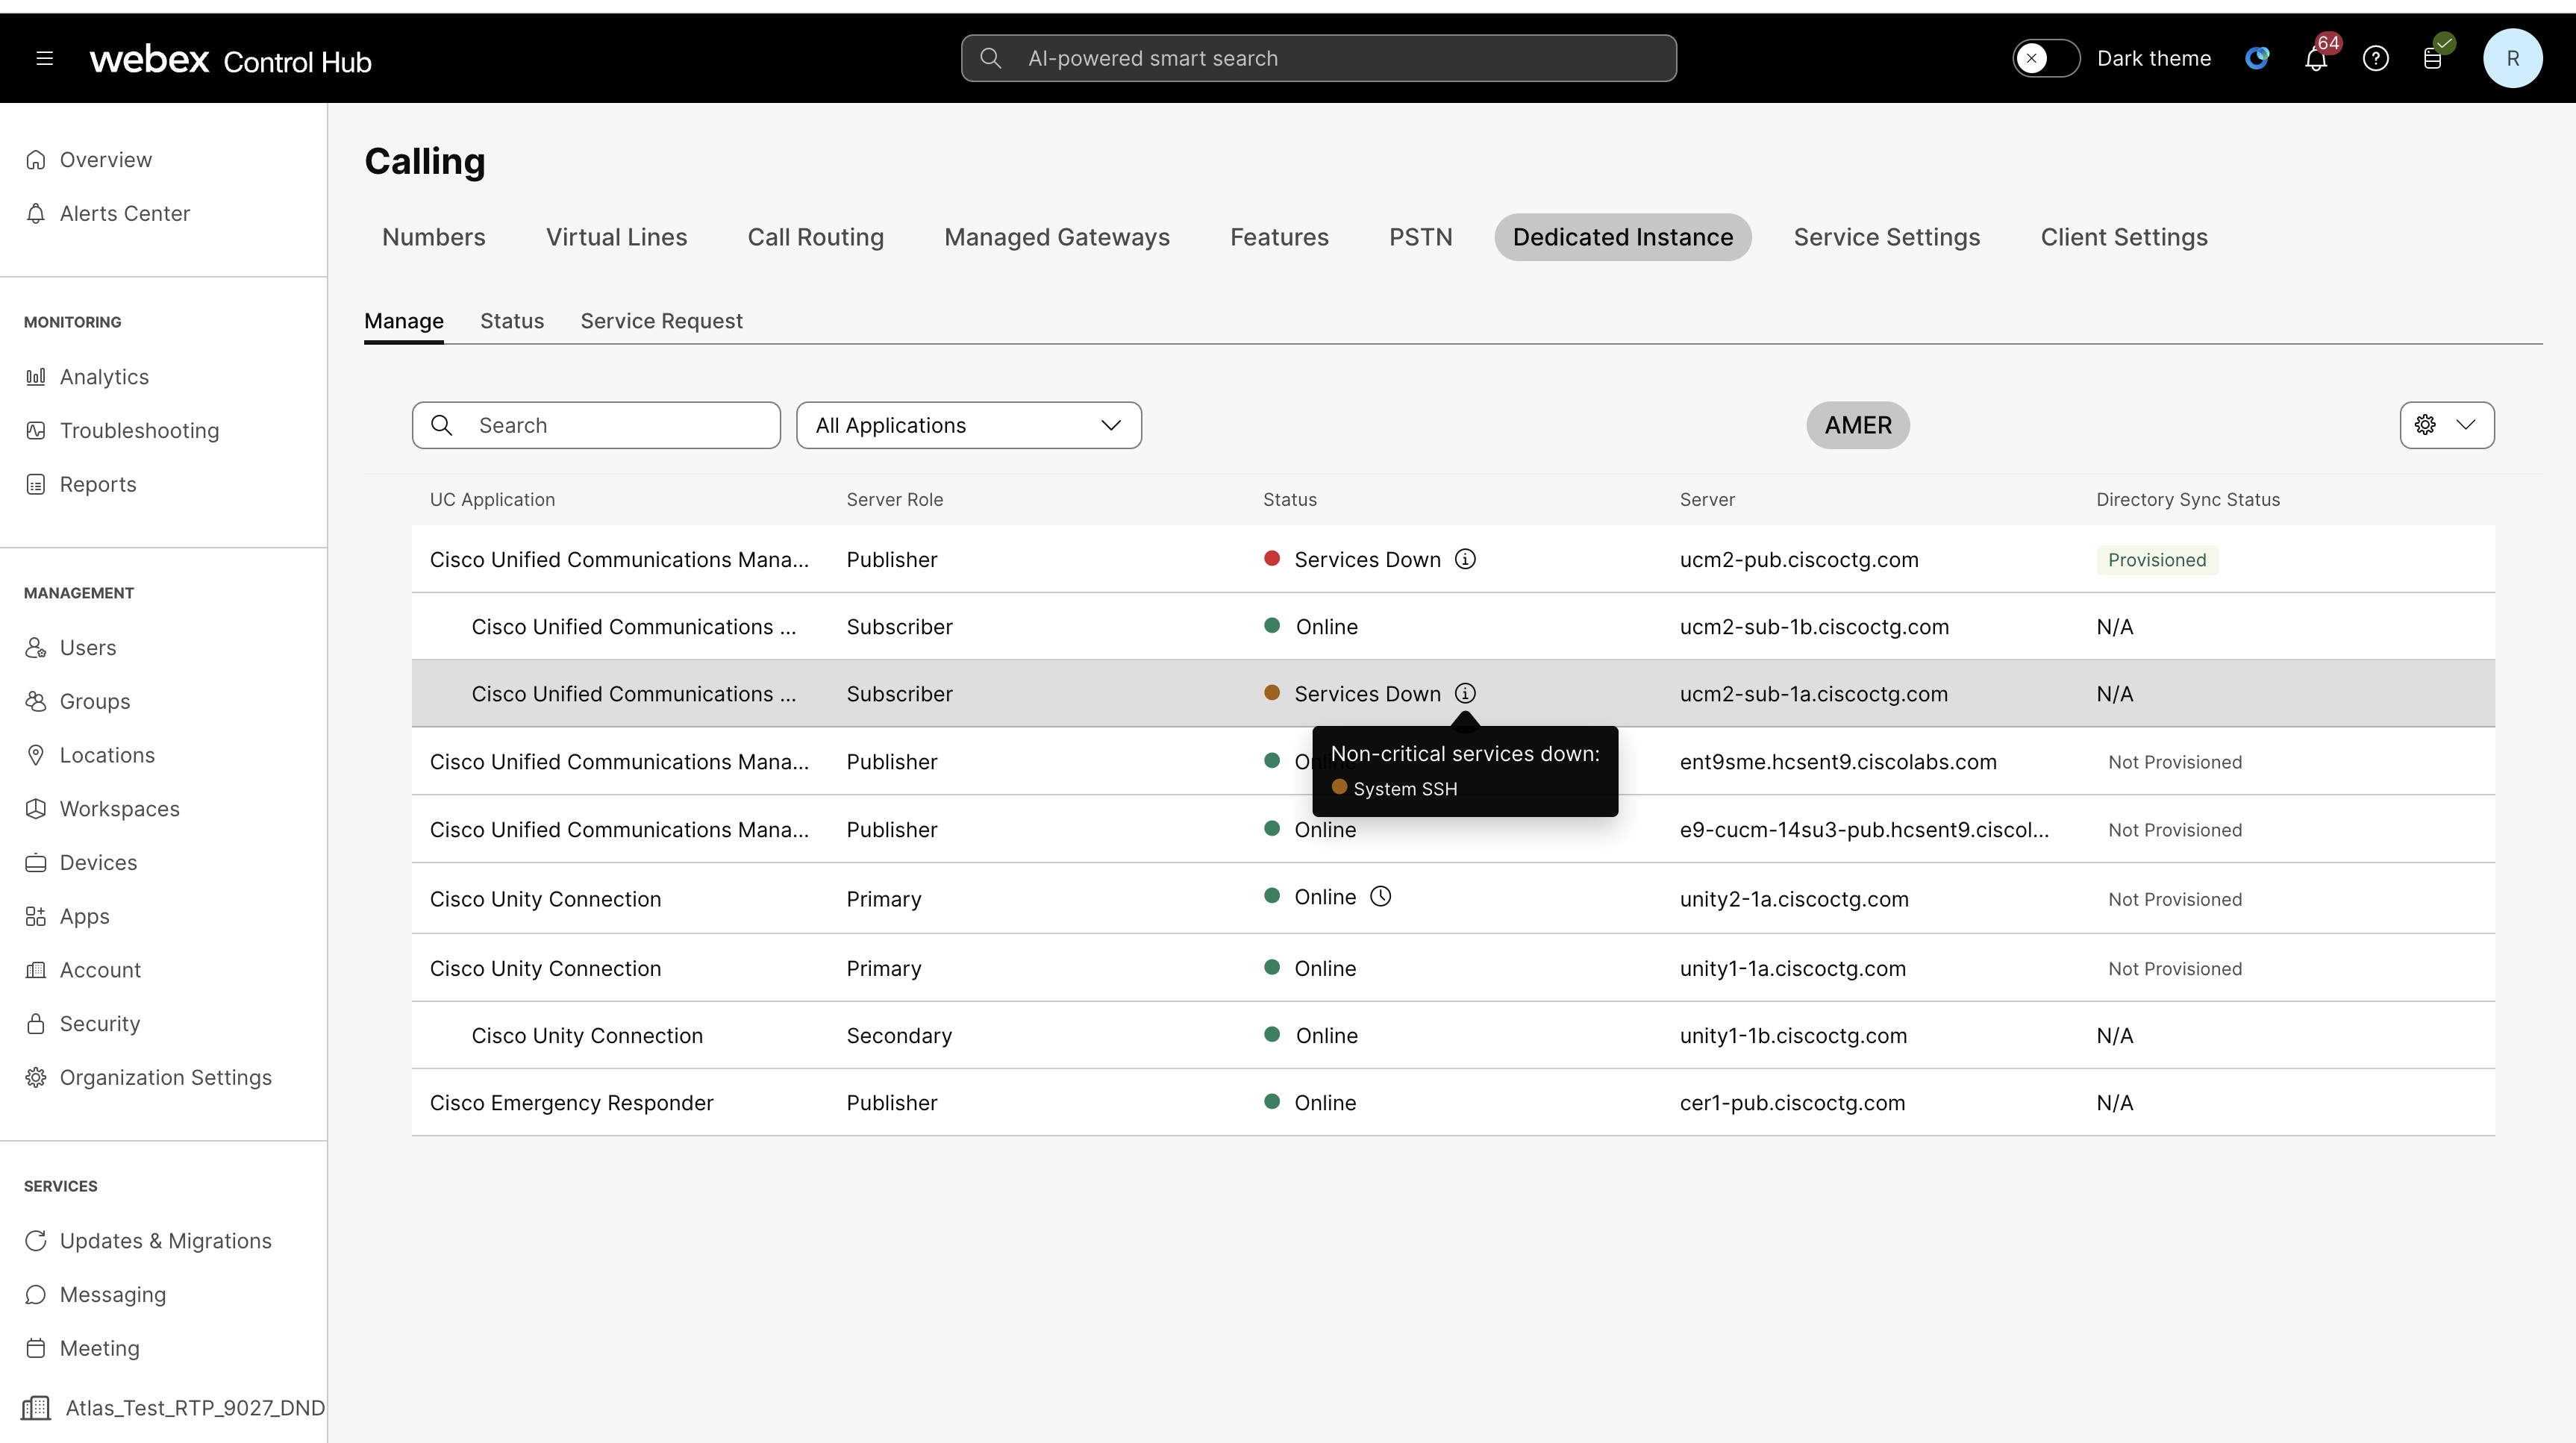
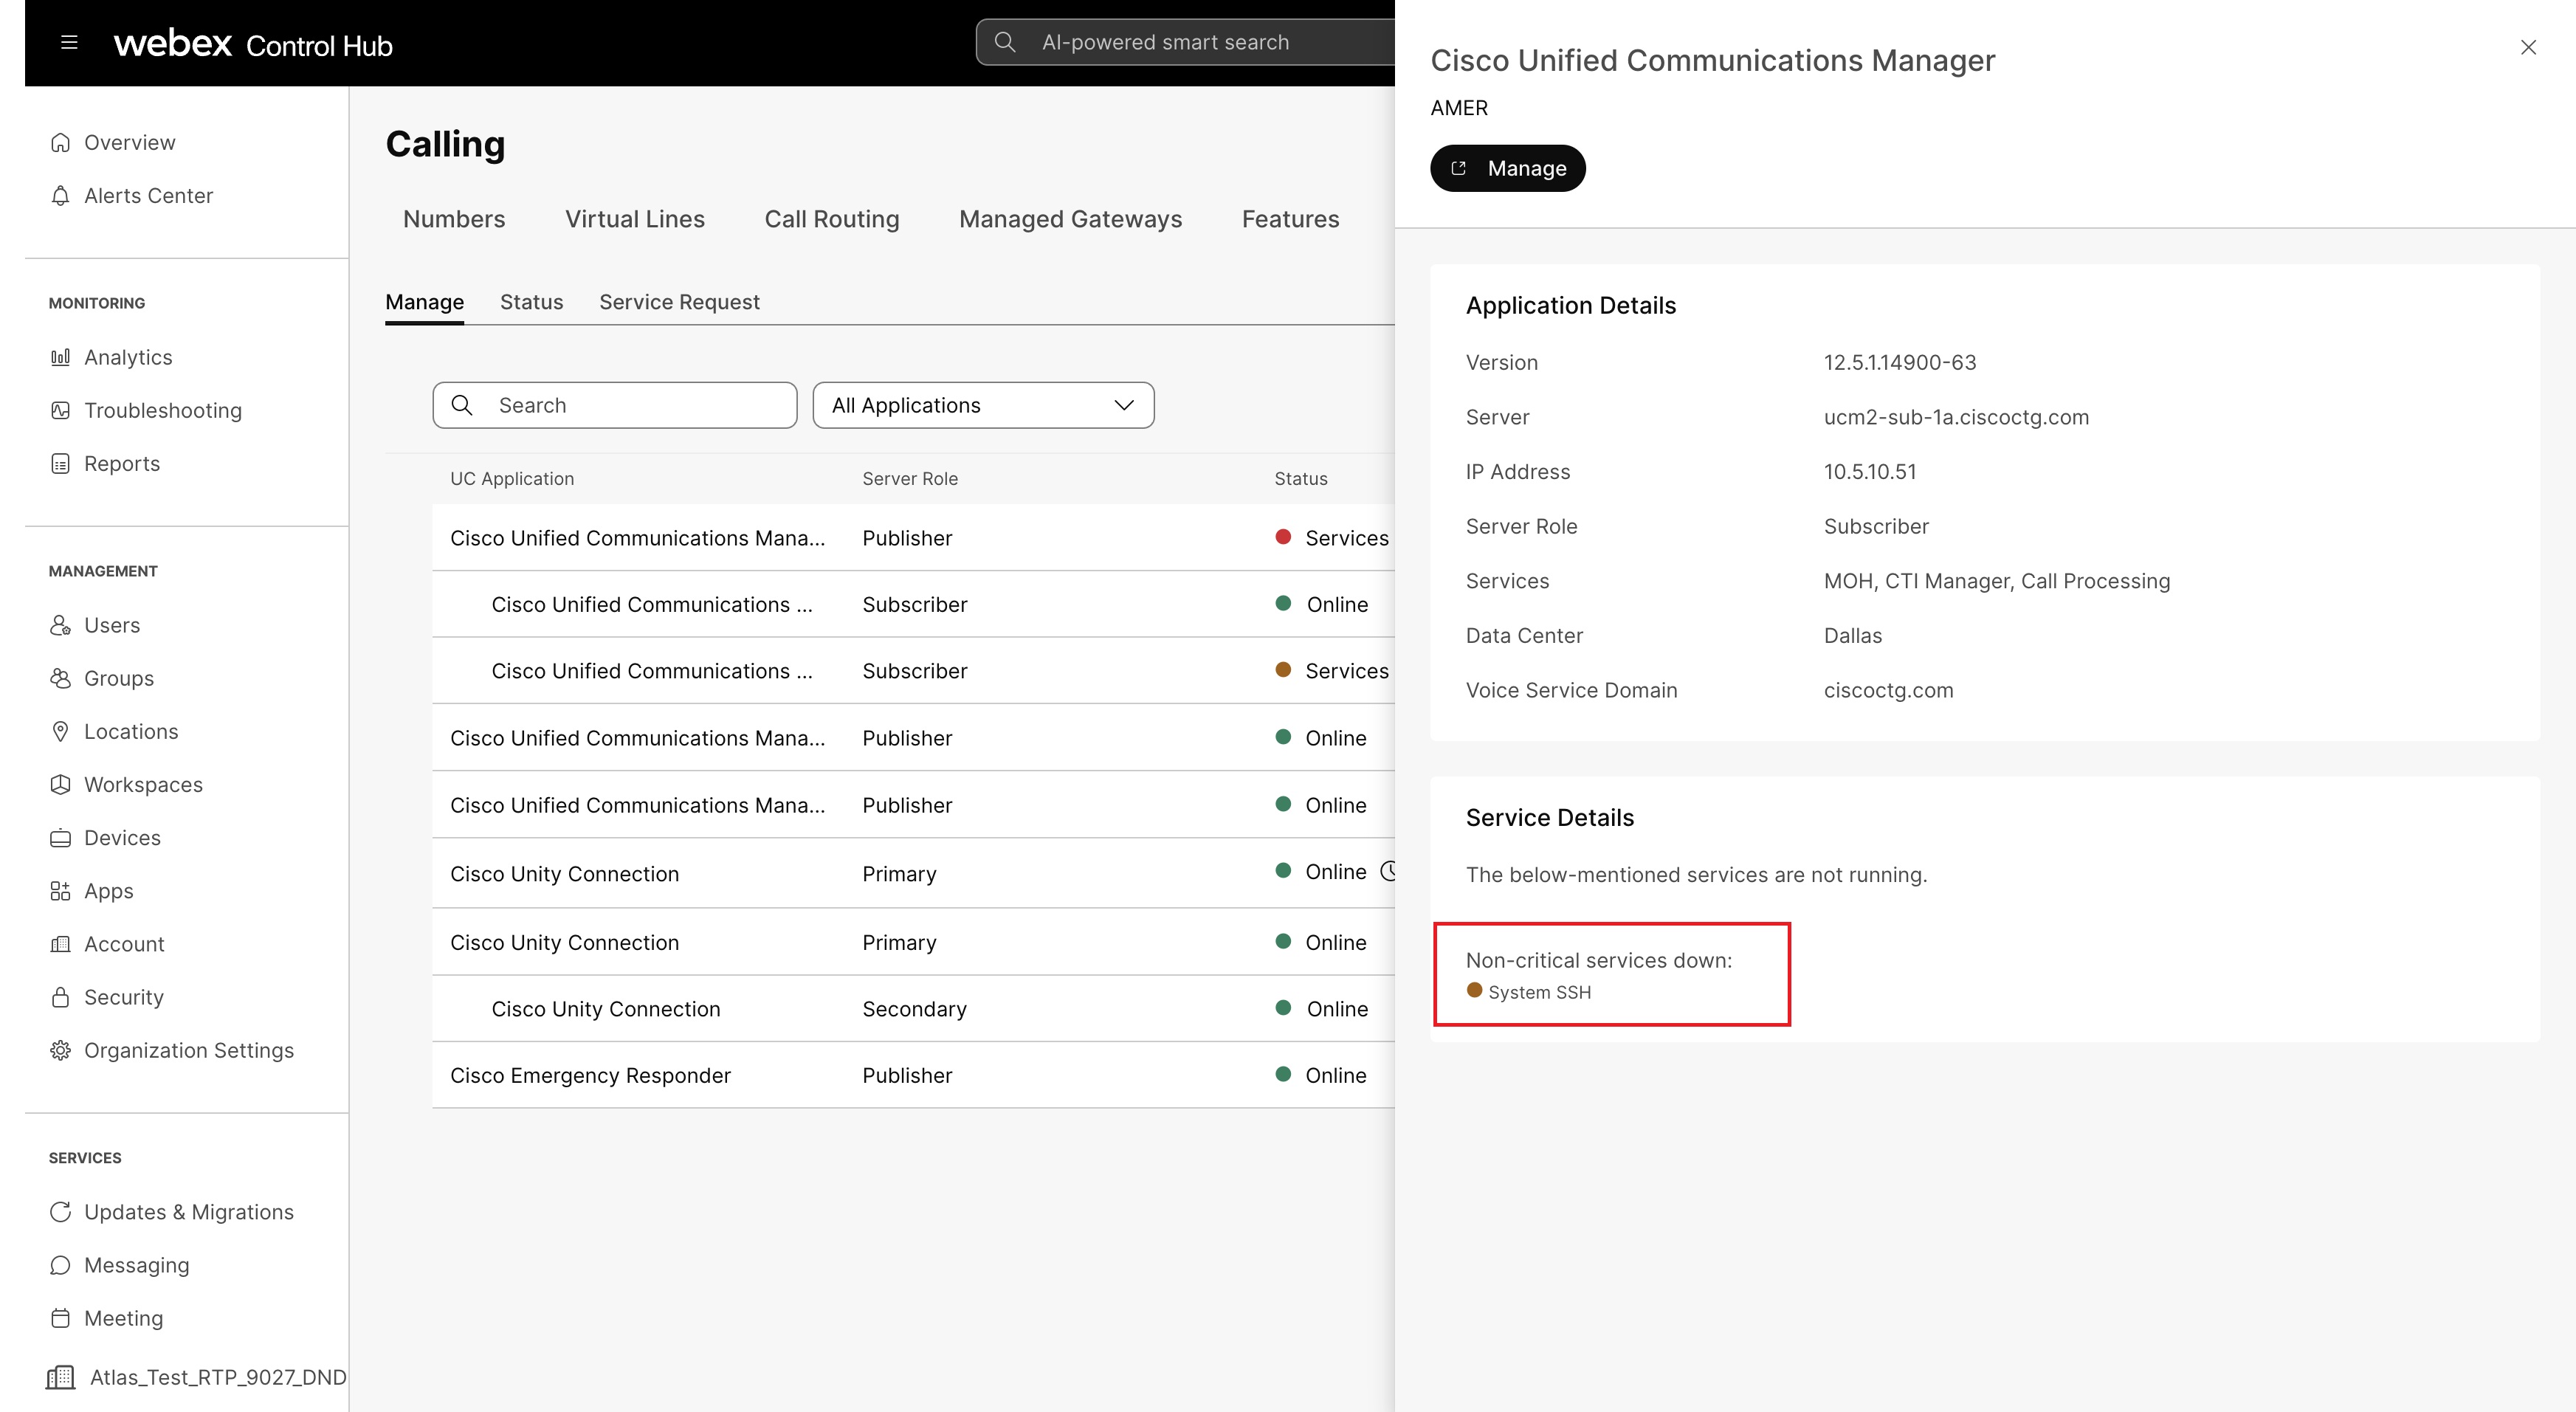
Lendas de alertas
| Status | Cor | Descrição |
| On-line | Verde | Indica que o nó está funcionando normalmente sem problemas |
| Manutenção | Alaranjado | Indica que o nó está passando por uma manutenção |
| Serviços inativos | Vermelho | Indica que um ou mais serviços essenciais estão inativos no nó |
| Serviços inativos | Alaranjado | Indica que um ou mais serviços não essenciais estão inativos no nó ou que o agente está off-line |
Alerta de expiração do certificado
O Control Hub envia alertas de expiração do certificado aos clientes 67 dias antes da data de expiração e depois a cada 12 dias, até que o certificado seja renovado.
- Certificados gerenciados e de propriedade do cliente - Um alerta proativo é enviado pelo Control Hub, e você é responsável por renovar e gerenciar o certificado.
- Certificados gerenciados e de propriedade da Cisco - Um alerta proativo é enviado pelo Control Hub, e somos responsáveis por renovar e gerenciar o certificado.
Configure um alerta proativo para receber uma notificação quando um certificado expirar.
Definições de alarme de status do aplicativo Control Hub
Para obter uma lista das definições de alarme disponíveis para Instância Dedicada, consulte Definições de alarme de status do aplicativo Control Hub.
Para alertas de aplicativos de Comunicação Unificada, você pode configurar os alertas abaixo:
- Alertas de eventos críticos de aplicativos de UC - Receba notificações de eventos críticos suportados coletados de aplicativos de UC.
- Alertas de eventos de anomalia baseados em IA - Receba alertas baseados em IA para cenários como anomalia telefônica, registro telefônico e anomalia de chamada.
Para obter mais informações, consulte Alertas no Control Hub.
Antes de começar
- Você deve ser um parceiro ou administrador do cliente com direitos administrativos totais para criar regras de alerta.
- As mensagens devem estar habilitadas para a organização se você quiser enviar alertas para um espaço do aplicativo Webex.
- Os webhooks devem ser habilitados no nível da organização antes que você possa usar os webhooks como um canal de entrega.
Eventos críticos do aplicativo de comunicação unificada
Use essa regra para receber alertas de eventos críticos. Os eventos de origem vêm de aplicativos de UC e são mapeados de acordo com a gravidade que o administrador escolhe ao criar a regra.
Como criar uma regra
- Entre no Control Hub e acesse Notificações > Minhas regras.
- Clique em Criar regra.
- Na seção Resumo, configure a regra de serviços.
- Na lista de serviços, escolha Chamando.
- Na lista Tipo, escolha os eventos críticos do aplicativo Cloud Intelligence UC.
- Selecione a severidade preferida.
- Esse campo mostra a gravidade ou a importância de um alerta. Você pode escolher o nível de severidade como Alto, Médio ou Baixo.
- Consulte a seção Tabela de severidade para saber mais sobre o Control Hub e a gravidade do tipo de alerta.
- Consulte a tabela da lista de eventos críticos para saber mais sobre os diferentes nomes, descrições e níveis de severidade do alerta.
- Insira um título para a nova regra.
- Verifique se o botão de alertas está ATIVADO para receber notificações do
alerta.
Quando DESATIVADO, os usuários não receberão alertas.
- Na seção Definição de regras, selecione o tipo de aplicativo e escolha cluster de aplicativos como cluster completo ou associado que deve receber alertas críticos.
- Na seção Canal de entrega, escolha como receber os alertas:
- E-mail— Insira os endereços de e-mail de quem receberá os alertas.
- Espaço Webex— Digite o nome do espaço para receber o alerta como mensagens em
um espaço. O bot só envia mensagens aos destinatários que são adicionados ao canal de entrega de e-mail.
Sua organização deve ter o sistema de mensagens habilitado para que o aplicativo Webex use um espaço como canal de entrega.
- Webhook— Marque essa caixa de seleção se quiser usar o alerta com aplicativos de terceiros.
- Clique em Salvar.
Depois que as regras são criadas, são necessárias no máximo 6 horas para começar a receber as notificações.
Tabela de severidade
O monitoramento envia alertas de eventos críticos de aplicativos de UC somente para os fatores abaixo:
| Gravidade do Control Hub | Gravidade do tipo de alerta |
|---|---|
|
Alto Envia somente os eventos críticos de maior prioridade. | Crítico, alerta |
|
Médio Envia eventos de alta prioridade e eventos críticos de média prioridade. | Crítico, alerta, erro, aviso |
|
Baixo Envia todos os eventos críticos suportados na regra. | Crítico, Alerta, Erro, Advertência, Informativo |
Lista de eventos críticos
A lista de eventos críticos mostra os alertas que podem acionar notificações para os clusters de aplicativos de gravidade e UC selecionados.
| Nome do alerta | Descrição | Severidade |
|---|---|---|
| Falha no Cisco DRF | Esse alerta ocorre quando o evento drfFailure é gerado. | Crítico |
| Falha de hardware | Esse alerta ocorre quando o evento HardwareFailure é gerado. Isso indica que ocorreu um evento de falha de hardware (falhas na unidade de disco, falhas na fonte de alimentação,...). | Crítico |
| Cadeia de pesquisa do arquivo de log encontrada | Esse alerta ocorre quando o evento LogFileSearchStringFound é gerado. Isso indica que a string de pesquisa foi encontrada no arquivo de log. | Crítico |
| Correspondência de string de log do Syslog encontrada | Esse alerta ocorre quando o evento SysLogStringMatchFound é gerado. Isso indica que foi encontrada uma mensagem de syslog com a string de pesquisa correspondente. | Crítico |
| Correspondência de gravidade do SysLogs encontrada | Esse alerta ocorre quando o evento SysLogSeverityMatchFound é gerado. Isso indica que foi encontrada uma mensagem de syslog com o nível de severidade correspondente. | Crítico |
| A marca d'água máxima da partição de log foi excedida | Esse alerta ocorre quando o evento LogPartitionHighWatermarkExceeded é gerado. Isso indica que a porcentagem de espaço em disco usado na partição de log excedeu a marca d'água alta configurada. | Crítico |
| A marca d'água baixa da partição de log foi excedida | Esse alerta ocorre quando o evento LogPartitionLowWatermarkExceeded é gerado. Isso indica que a porcentagem de espaço em disco usado na partição de log excedeu a marca d'água baixa configurada. | Crítico |
| A marca d'água alta da partição de reposição foi excedida | Esse alerta ocorre quando o evento SparePartitionHighWatermarkExceeded é gerado. Isso indica que a porcentagem de espaço em disco usado na partição de reposição excedeu a marca d'água alta configurada. | Crítico |
| A marca d'água baixa da partição de reposição foi excedida | Esse alerta ocorre quando o evento SparePartitionLowWatermarkExceeded é gerado. Isso indica que a porcentagem de espaço em disco usado na partição de reposição excedeu a marca d'água baixa configurada. | Crítico |
| Arquivo CoreDump encontrado | Esse alerta ocorre quando o evento CoreDumpFileFound é gerado. Isso indica que um arquivo de despejo principal foi encontrado no sistema. | Crítico |
| Erro de criptografia CCM detectado | Esse alerta ocorre quando o evento CCMEncryptionErrorDetected é gerado. | Crítico |
| Falha na entrega do Syslog remoto do TCP | Esse alerta ocorre quando a entrega de alarmes, auditorias ou eventos de geração de rsyslog para os servidores syslog remotos configurados falha. O motivo pode ser que o servidor syslog configurado esteja inativo, o TCP não esteja configurado na porta 601 ou haja uma falha na rede. | Crítico |
| Falha na entrega do TLSRemoteSyslog | Esse alerta ocorre quando a entrega de alarmes, auditorias ou eventos de geração de rsyslog para os servidores syslog remotos configurados falha. O motivo pode ser que o servidor syslog configurado esteja inativo, ou que o TLS sobre TCP não esteja configurado na porta 6514, ou que haja uma falha na rede, ou que o certificado do servidor syslog remoto não tenha sido carregado para o Tomcat trust. Unified CM | Crítico |
| Servidor Syslog remoto inacessível | Esse alerta ocorre quando o servidor syslog remoto configurado para um serviço não está acessível. O motivo pode ser que o servidor syslog configurado é inválido, ou quando o servidor syslog está inativo, ou quando o servidor syslog não está configurado para os protocolos UDP/TCP/TLS para as portas 514/601/6514. | Alerta |
| Estouro do log de auditoria devido à purga do LPM | Esse alarme indica que ocorreu um estouro devido à limpeza pela lógica de limpeza do LPM. Quando o uso total de espaço em disco da partição de log ultrapassa a marca d'água máxima configurada, a lógica de limpeza da ferramenta LPM exclui os arquivos mais antigos da partição de log para que os novos registros possam ser gravados. | Alerta |
| Falha na autenticação | Esse alerta é acionado quando o número de eventos AuthenticationFailed excede o limite (configurado) durante o intervalo de tempo (configurado). Esse evento AuthenticationFailed ocorre quando há falha de autenticação na tentativa de login . | Alerta |
| O total de processos e segmentos excedeu o limite | Esse alerta ocorre quando o evento TotalProcessesAndThreadsExceededThresholdStart é gerado. Isso indica que o número total atual de processos e threads excedeu o número máximo de tarefas configuradas para o Cisco RIS Data Collector Service Parameter. Essa situação pode indicar que algum processo está vazando ou que algum processo tem vazamento de linha. | Alerta |
| Pouco espaço em disco disponível na partição ativa | Esse alerta ocorre quando a porcentagem de espaço disponível em disco da Partição Ativa é menor que o valor configurado. | Alerta |
| Pouco espaço disponível em disco na partição inativa | Esse alerta ocorre quando a porcentagem de espaço disponível em disco da partição inativa é menor que o valor configurado. | Alerta |
| Baixo espaço em disco disponível na partição Swap | Esse alerta ocorre quando a porcentagem de espaço disponível em disco da partição de troca é menor que o valor configurado. | Alerta |
| Falha na replicação do banco de dados | Esse alerta ocorre quando há erros de replicação do banco de dados do CallManager. | Alerta |
| Falha na notificação de alteração do banco de dados | Esse alerta ocorre quando o Cisco Database Notification Service está enfrentando problemas e pode ser interrompido. Essa condição indica que as solicitações de notificação de alterações em fila no banco de dados estão travadas e as alterações feitas no sistema não estão entrando em vigor. | Alerta |
| Pegging da CPU | Esse alerta ocorre quando a porcentagem da carga da CPU em um servidor está acima da porcentagem configurada para o período de tempo configurado. | Alerta |
| Memória virtual de baixa disponibilidade | Esse alerta ocorre quando a porcentagem de memória virtual disponível é menor que o valor configurado. | Alerta |
| Serviço crítico inativo | Esse alerta ocorre quando o status operacional do serviço está INATIVO. | Alerta |
| Servidor inativo | Esse alerta ocorre quando o nó remoto está inacessível. | Alerta |
| Versão do sistema incompatível | Esse alerta ocorre quando há incompatibilidade na versão do sistema. | Alerta |
| Tabela de replicação de banco de dados fora de sincronia | Esse alerta é acionado quando ocorre o (s) evento (s) IDSReplicationFailure com o número de alarme 888. Uma ou mais tabelas podem estar fora de sincronia. Entre em contato Cisco TAC e agende a manutenção. | Alerta |
| Os registros de auditoria excedem o limite configurado | Esse alarme indica que a porcentagem de espaço em disco configurado para o registro de auditoria de aplicativos excede o limite configurado. Os arquivos de registros de auditoria serão substituídos mais cedo ou mais tarde, dependendo da frequência do registro de auditoria pelos aplicativos CUCM . | Alerta |
| Estouro do log de auditoria devido à rotação do log | Esse alarme indica que o estouro do registro de auditoria ocorreu. Um arquivo de registro de auditoria existente é sobrescrito, resultando em excesso e eventual perda de dados de auditoria. | Alerta |
| Cisco HA Proxy Service inativo | Esse alerta ocorre quando o Cisco HAProxy Service fica inativo. | Alerta |
| Evento de sobrevivência | Esse alerta ocorre quando nenhum dos nós da Instância Webex Calling Dedicada está acessível. | Crítico |
| Node de sobrevivência remota não acessível | Esse alerta ocorre quando um ou mais nós do Remote Survivable não estão acessíveis aos nós da Instância Webex Calling Dedicada. | Crítico |
| Falha no trabalho do CarScheduler | Esse alerta ocorre quando o evento CarSchedulerJobFailed é gerado. Isso indica que o trabalho agendado do CAR falhou. | Crítico |
| Motor Crítico Carids | Esse alerta ocorre quando o evento CaridsEngineCritical é gerado. Esse alarme não compromete os dados nem impede o uso do sistema. | Crítico |
| Falha no motor CARIDS | Esse alerta ocorre quando o evento CARidsEngineFailure é gerado. Este é um alarme combinado para situações de emergência e erro. Ocorreu algo inesperado que pode comprometer os dados ou o acesso aos dados ou causar a falha do CAR IDS. | Crítico |
| Tentativa de chamada bloqueada pela política | Esse alerta ocorre quando o (s) evento (s) CallAttemptBlockedByPolicy é gerado (s). Isso indica que uma chamada foi tentada, mas bloqueada ou rejeitada pelo ponto de decisão política (PDP). | Crítico |
| A EMC falhou no cluster local | Esse alerta ocorre quando o (s) evento (s) EMCCFailedInLocalCluster é gerado (s). Isso indica que há uma falha de login do EMCC no Call Manager local. | Crítico |
| A EMC falhou no cluster remoto | Esse alerta ocorre quando o (s) evento (s) EMCCFailedInRemoteCluster é gerado (s). Isso indica que há uma falha de login do EMCC em um Call Manager remoto. | Crítico |
| Falha na entrada do usuário | Esse alerta ocorre quando o (s) evento (s) userInputFailure é gerado (s). Isso indica que há uma falha de login no EMCC devido à entrada inválida do usuário. | Crítico |
| Número de dispositivos registrados excedido | Esse alerta ocorre quando o (s) evento (s) NumDevRegExceeded é gerado (s). | Crítico |
| Falha no arquivo CDRagentSend | Esse alerta ocorre quando o evento CDRagentSendFileFailed é gerado. Isso indica que o agente CDR não pode enviar arquivos CDR do nó CCM para o nó do repositório CDR dentro do cluster CCM. | Crítico |
| Falha na entrega do arquivo CDR | Esse alerta ocorre quando o evento CDRFileDeliveryFailed é gerado. Isso indica que a entrega de arquivos CDR por FTP para o servidor de cobrança externo falhou. | Crítico |
| A falha na entrega do arquivo CDR continua | Esse alerta ocorre quando o evento CDRFileDeliveryFailureContinues é gerado. Isso indica que a entrega de arquivos CDR por FTP para o servidor remoto externo falhou após 3 ou mais tentativas. | Crítico |
| A marca d'água alta do CDR foi excedida | Esse alerta ocorre quando o evento CdrHwmExceeded é gerado. Isso indica que a marca d'água alta para arquivos CDR foi atingida, alguns arquivos CDR entregues com sucesso foram excluídos. | Crítico |
| Espaço máximo em disco do CDR excedido | Esse alerta ocorre quando o evento CDRMaximumDiskSpaceExceeded é gerado. Isso indica que o uso do disco dos arquivos CDR excedeu a alocação máxima de disco. Alguns arquivos não entregues foram excluídos. | Crítico |
| Rastreamento de chamadas malicioso | Esse alerta ocorre quando o evento MaliciousCall é gerado. | Crítico |
| Falha na configuração do TCP | Esse alerta ocorre quando o evento TcpSetupToImeFailed é gerado. Esse alarme ocorre quando não Unified CM é possível estabelecer uma conexão TCP com um servidor IME. Geralmente ocorre quando o endereço IP e a porta do servidor IME estão configurados incorretamente ou quando um problema de conectividade da Intranet está impedindo a configuração da conexão. | Crítico |
| Falha na conexão TLS com o IME | Esse alerta ocorre quando o evento TlsConnectionToImeFailed é gerado. Não foi possível estabelecer uma conexão TLS com o servidor IME devido a um problema com o certificado apresentado pelo servidor IME. (Por exemplo, não está na Unified CM CTL ou está na CTL, mas expirou). | Crítico |
| Credenciais inválidas | Esse alerta ocorre quando o evento InvalidCredentials é gerado. A conexão com o servidor IME não pôde ser concluída, pois o nome de usuário e/ou a senha configurados em Unified CM não coincidem com os configurados no servidor IME | Crítico |
| IME sobre a cota | Esse alerta ocorre quando o evento IMEOverQuota é gerado. Cada servidor IME tem uma cota fixa no número total de DIDs que ele pode gravar no cache distribuído do IME. Quando esse alarme é gerado, significa que, em todos os Unified CM clusters que estão utilizando o mesmo servidor IME, a cota para o cache distribuído do IME foi excedida. | Crítico |
| Cache distribuído IME inativo | Esse alerta ocorre quando o evento IMEDistributedCacheInactive é gerado. Esse alarme é gerado quando se Unified CM tenta se conectar ao servidor IME, no entanto, o cache distribuído IME não está ativo no momento | Crítico |
| Identificadores alternativos insuficientes | Esse alerta ocorre quando o evento InsufficientFallbackIdentifiers é gerado. Esse alarme é gerado quando Unified CM está processando uma chamada IME e está tentando alocar um DID substituto PSTN e uma sequência de dígitos DTMF para associar a essa chamada. No entanto, existem muitas chamadas IME em andamento que estão utilizando esse mesmo DID alternativo e, como resultado, não há mais sequências de dígitos DTMF que possam ser alocadas para essa chamada. Dessa forma, essa chamada continuará, mas o retorno no meio da chamada não será possível para essa chamada. | Crítico |
| Licença inteligente em Eval | O sistema está operando no Modo de Avaliação, que expirará em breve. | Crítico |
| SmartLicenseNoProvision_EvalExpired | O período de avaliação da licença expirou. | Crítico |
| SmartLicenseInOverage_AuthorizationExpired | A autorização da licença expirou. | Crítico |
| SmartLicenseNoProvision_AuthorizationExpired | A autorização da licença expirou. | Crítico |
| O registro da Smart License expirou | O registro da licença expirou e o sistema não está registrado no nosso satélite Cisco Smart Software Manager | Crítico |
| SmartLicenseInOverage_OutOfCompliance | O sistema está operando com um número insuficiente de licenças. | Crítico |
| SmartLicenseNoProvision_OutOfCompliance | O sistema está operando com um número insuficiente de licenças. | Crítico |
| Erro de comunicação da Smart License | O sistema falhou ao se comunicar com Cisco Smart Software Manager nosso satélite | Crítico |
| O registro da Smart License expirará em breve | O registro com Cisco Smart Software Manager nosso satélite expirará em breve. | Crítico |
| A autorização da Smart License expirará em breve | O período de autorização da licença expirará em breve. | Crítico |
| Falha na renovação do Smart License | A renovação da autorização da licença falhou. | Crítico |
| Falha no novo registro do Smart License | A renovação do registro da licença falhou. | Crítico |
| O controle de exportação de licenças inteligentes não é permitido | Este Unified Communications Manager não está licenciado para operar no modo misto | Crítico |
| SmartLicense_Reservation_InEval | A reserva de licenças está ativada neste sistema e o sistema está operando no Modo de Avaliação, que expirará em breve. | Crítico |
| SmartLicense_Reservation_NoProvision_EvalExpired | A reserva de licenças está ativada nesse sistema e o período de avaliação da licença expirou. | Crítico |
| SmartLicense_SLR_InOverage_NotAuthorized | A reserva de licenças está ativada neste sistema. Este sistema está operando com um número insuficiente de licenças e o período excedente está ativo. | Crítico |
| SmartLicense_SLR_NoProvision_NotAuthorized | A reserva de licenças está ativada neste sistema. Este sistema está operando com um número insuficiente de licenças e o período excedente expirou. | Crítico |
| SmartLicense_Reservation_ExportControlNotAllowed | A reserva de licenças está ativada e esse sistema não está licenciado para operar no modo misto. | Crítico |
| Alerta de igualdade de dados | Esse alerta ocorre quando o evento IMequalityAlertEntry é gerado. Esse alarme é gerado quando Unified CM um número substancial de chamadas IME falha na PSTN ou falha na configuração devido a problemas de qualidade da rede IP. Há dois gatilhos para esse alarme. Uma é quando uma grande fração das chamadas IME atualmente ativas tem todas as solicitações de fallback, ou retornaram, para o PSTN. A outra é quando uma grande fração das tentativas recentes de chamadas não foram feitas por IP e, em vez disso, foram para o PSTN. | Crítico |
| Comunicação de licença inteligente | O sistema não conseguiu estabelecer comunicação usando o modo de transporte inteligente, portanto, continuará a usar o Call Home para comunicação com Cisco Smart Software Manager ou via satélite. | Crítico |
| Lista de rotas esgotada | Esse alerta ocorre quando o número de eventos RouteListExhausted excede o limite configurado durante o intervalo de tempo configurado. Isso indica que todos os canais disponíveis definidos na lista de rotas estão ocupados. | Crítico |
| Relatórios de qualidade de voz excessiva | Esse alerta ocorre quando o número de relatórios de qualidade de voz excede o limite configurado durante o intervalo de tempo configurado. | Crítico |
| Medialista exausto | Esse alerta ocorre quando o número de eventos MediaResourceListExhausted excede o limite configurado durante o intervalo de tempo configurado ou quando pode haver um problema de configuração. Isso indica que todos os recursos de mídia disponíveis definidos na lista de mídia estão ocupados ou que um recurso de mídia não pode ser alocado. | Crítico |
| Comece a limitar as assinaturas BLF da lista de chamadas | Esse alerta ocorre quando o evento beginThrottlingCallListBlfSubscriptions é gerado. Isso indica que Cisco CallManager iniciou uma limitação das assinaturas do CallList BLF para evitar uma sobrecarga do sistema. | Crítico |
| Código amarelo | Esse alerta ocorre quando o evento Cisco CallManager CodeYellowEntry é gerado. | Crítico |
| Link SDL fora de serviço | Esse alerta ocorre quando o evento sdlLinkOOS é gerado. Esse evento indica que o local Cisco CallManager perdeu a comunicação com o controle remoto Cisco CallManager. Esse evento geralmente indica erros de rede ou um controle remoto Cisco CallManager não executado. | Crítico |
| Sessões RTMT excedem o limite | Esse alerta ocorre quando o número de sessões RTMT está acima do limite configurado. | Crítico |
| Aumento do número de gateways registrados | Esse alerta ocorre quando o número de gateways registrados no cluster aumenta entre pesquisas consecutivas. | Crítico |
| Diminuição do número de gateways registrados | Esse alerta ocorre quando o número de gateways registrados no cluster diminui entre pesquisas consecutivas. | Crítico |
| Aumento do número de dispositivos de mídia registrados | Esse alerta ocorre quando o número de dispositivos de mídia registrados no cluster aumenta entre pesquisas consecutivas. | Crítico |
| Diminuição do número de dispositivos de mídia registrados | Esse alerta ocorre quando o número de dispositivos de mídia registrados no cluster diminui entre pesquisas consecutivas. | Crítico |
| Número de telefones registrados caiu | Esse alerta ocorre quando o número de telefones registrados no cluster cai mais do que a porcentagem configurada entre pesquisas consecutivas. | Crítico |
| Egging de CPU do nó de processamento de chamadas | Esse alerta ocorre quando a porcentagem da carga da CPU em um servidor de processamento de chamadas excede a porcentagem configurada para o período configurado. | Crítico |
| Prevenção de bloqueio DDR | Esse alerta é acionado quando ocorre o (s) evento (s) IDSReplicationFailure com o número de alarme 31. Invocar um procedimento proativo para evitar a negação de serviço. Esse procedimento não afetará o processamento de chamadas. Ignore os alarmes de replicação durante esse processo. O procedimento leva até 60 minutos para ser concluído. Verifique se o status de replicação RTMT é 2 em cada nó para garantir que o procedimento seja concluído. Não reinicie o sistema durante esse processo. | Crítico |
| DDR Down | Esse alerta é acionado quando ocorre o (s) evento (s) IDSReplicationFailure com o número de alarme 32. Um procedimento de recuperação automática está sendo executado em segundo plano e não é necessária nenhuma ação. O procedimento leva cerca de 15 minutos para ser concluído. Verifique se o status de replicação RTMT é 2 em cada nó para garantir que o procedimento seja concluído. | Crítico |
| Canal MGCPD fora de serviço | Esse alerta ocorre quando o MGCP DChannel está fora de serviço | Crítico |
| Status do serviço IME | Esse alerta é gerado quando o valor do contador IMEServiceStatus é 2=Não saudável. Isso indica o status de integridade dessa instância do serviço IME. Um valor de 0 indica um status desconhecido, provavelmente indicando que o serviço IME não foi ativado. Um valor de 1 indica integridade: o serviço IME foi ativado e os procedimentos de handshake foram concluídos com êxito com o servidor IME. Um valor de 2 indica problemas de integridade: o serviço IME foi ativado, mas não concluiu com êxito os procedimentos de handshake com o servidor IME. Observe que, se um servidor IME secundário estiver configurado para o serviço IME, esse contador refletirá o status do handshake dos servidores IME primário e secundário. | Crítico |
| Localização fora do recurso | Esse alerta ocorre quando o evento LocationOutOfResource é gerado. Isso indica que um ou todo o áudio ou vídeo ou a largura de banda imersiva de um local ou link estão esgotados. | Crítico |
| Falha na autenticação ILS TLS | Esse alerta ocorre quando o evento IlstlsAuthenticationFailed é gerado. Não foi possível estabelecer uma conexão TLS com o serviço ILS remoto devido a um problema com o certificado apresentado pelo cluster remoto. (Por exemplo, não está na Unified CM CTL ou está na CTL, mas expirou). Se você estiver usando certificados de identidade assinados pela CA sem trocar certificados, a senha deverá ser fornecida com "Usar certificado TLS”. | Crítico |
| Falha na autenticação do ILSPWD | Esse alerta ocorre quando o evento ILSpwdAuthenticationFailed é gerado. Não foi possível estabelecer uma conexão com o serviço ILS remoto devido a um problema de autenticação de senha com o cluster remoto. | Crítico |
| ILS Hub Cluster inacessível | Esse alerta ocorre quando o evento ILShubClusterUnreachable é gerado. Não foi possível estabelecer uma conexão com o servidor ILS remoto. O ILS tentará periodicamente se conectar novamente ao cluster de hub. Se a condição for causada por um problema temporário de conectividade com a Internet, o problema será reparado automaticamente. | Crítico |
| Registro do gateway de gravação rejeitado | Esse alerta ocorre quando o (s) evento (s) RecordingGatewayRegistrationRejected é gerado (s). O registro no gateway habilitado para gravação foi rejeitado após várias tentativas. | Crítico |
| Tempo limite de registro do gateway de gravação | Esse alerta ocorre quando o (s) evento (s) RecordingGatewayRegistrationTimeout é gerado (s). Nenhuma resposta do gateway habilitado para gravação após várias tentativas; ocorreu um tempo limite; o gateway foi marcado como fora de serviço | Crítico |
| Recursos de gravação não disponíveis | Esse alerta ocorre quando o (s) evento (s) RecordingResourcesNotAvailable é gerado (s). Recursos de mídia de gravação não disponíveis (telefone ou gateway) | Crítico |
| Falha na sessão de gravação do gateway | Esse alerta ocorre quando os eventos RecordingGatewaySessionFailed são gerados. A sessão de gravação do gateway foi encerrada inesperadamente | Crítico |
| Falha na configuração da chamada de gravação | Esse alerta ocorre quando os eventos RecordingCallSetupFail são gerados. O evento é acionado quando a configuração da chamada de gravação falhou ou a solicitação de gravação para outro cluster atingiu o tempo limite | Crítico |
| Sessão de gravação encerrada inesperadamente | Esse alerta ocorre quando o (s) evento (s) RecordingSessionTerminatedUnexpectely é gerado (s). O evento é acionado quando a sessão de gravação termina inesperadamente | Crítico |
| URI duplicado do ILS | Esse alerta ocorre quando o Cisco Unified Communications Manager identifica que aprendeu entradas de URI duplicadas via ILS durante uma chamada para o URI. Sempre que houver entradas duplicadas para um URI (como o URI user@example.com existente em dois clusters), a chamada sempre será roteada para o cluster do qual o URI foi aprendido pela primeira vez. As chamadas não serão roteadas para outras entradas duplicadas. | Crítico |
| Aviso de aproximação do limite de velocidade do IL | A contagem atual de pares atingiu 90% ou mais da capacidade da rede ILS. | Crítico |
| Limite de velocidade do IL excedido | O número de pares para esse cluster na rede ILS é maior do que o limite definido. ILSP_MSG_PEER_MAX O sistema poderá adicionar raios, hubs e catálogos importados continuamente; no entanto, somente o número máximo de pares será anunciado na rede ILS. | Crítico |
| Switches e pontos de acesso atingiram 75 por cento da capacidade | A contagem atual de registros para switches e pontos de acesso atingiu 75% da capacidade máxima de 50.000 registros. | Crítico |
| Os switches e o ponto de acesso atingiram 90% da capacidade | A contagem atual de registros de switches e pontos de acesso atingiu 90% da capacidade máxima de 50.000 registros. | Crítico |
| Switches e pontos de acesso atingiram 95 por cento da capacidade | A contagem atual de registros de switches e pontos de acesso atingiu 95% da capacidade máxima de 50.000 registros. | Crítico |
| Serviço Cisco WLC Sync inativo | Excedeu o número máximo de dispositivos (50000) nos switches e pontos de acesso . | Crítico |
| Login do Legacy CUP | Um Cisco Unified Personal Communicator cliente legado tentou fazer login no serviço Cisco Client Profile Agent | Crítico |
| InterclusterSyncAgent PeerDuplicate | Falha na sincronização do serviço Cisco Intercluster Sync Agent com o peer remoto | Crítico |
| Incompatibilidade de impressão digital do certificado ICSA | O serviço Cisco Intercluster Sync Agent detectou uma incompatibilidade de impressão digital no certificado que está sendo processado | Crítico |
| Falha na validação do certificado ICSA | O serviço Cisco Intercluster Sync Agent detectou um erro de validação no certificado que está sendo processado | Crítico |
| Conexão de sincronização do certificado ICSA recusada | O Cisco InterCluster Sync Agent Service detectou um erro de conexão recusada, pois a porta 37239 não estava acessível durante o processamento do certificado. | Crítico |
| Certificado ICSCA AsignedTrustCertFound | O serviço Cisco Intercluster Sync Agent detectou um certificado de confiança CA assinado | Crítico |
| Certificado ICSA em conflito | O serviço Cisco Intercluster Sync Agent detectou um conflito de certificado CA | Crítico |
| Erro ESPConfigAgentMemAllocError | O serviço Cisco Config Agent não conseguiu alocar memória | Crítico |
| Erro de gravação do arquivo ESP ConfigAgent | O serviço Cisco Config Agent não conseguiu gravar no sistema de arquivos | Crítico |
| Erro de rota estática de memória compartilhada do ESP ConfigAgent | O serviço Cisco Config Agent não pôde acessar a memória compartilhada de rota estática | Crítico |
| Interrupção na rede do ESP Config Agent | Interrupção na rede do Cisco Config Agent | Crítico |
| Rede do agente ESP Config restaurada | Rede do Cisco Config Agent restaurada | Crítico |
| Alta utilização de memória do ESP Config Agent | A utilização da memória virtual excedeu o limite configurado | Crítico |
| Alta utilização da CPU do ESP ConfigAgent | A utilização da CPU excedeu o limite configurado | Crítico |
| Erro de acesso do ESPConfigAgentLocalDB | O serviço Cisco Config Agent não conseguiu acessar o banco de dados local | Crítico |
| Erro de acesso remoto do ESPConfigAgent | O serviço Cisco Config Agent não conseguiu acessar um banco de dados remoto de IM e Presença | Crítico |
| Domínio de proxy do ESP ConfigAgent não configurado | O serviço Cisco Config Agent exige que o domínio padrão de IM esteja configurado | Crítico |
| Erro no banco de dados PE | Falha na pesquisa de informações | Crítico |
| Falha no PepeerNode | O Cisco Presence Engine serviço no nó de mesmo nível de um subcluster falhou | Erro |
| Falha na recuperação automática do PE | Cisco Presence Enginefalha na recuperação automática do serviço | Erro |
| Peload Highwatermark | Indica que o Cisco Presence Engine serviço excedeu o limite de utilização da CPU | Erro |
| Erro de sincronização do banco de dados PEIDs para IMDB | A sincronização entre o banco de dados de Cisco Unified CM IM e Presence e o banco de dados Cisco Unified Presence Engine falhou | Erro |
| Erro de assinatura do PEIDS | O Cisco Presence Engine serviço não conseguiu se inscrever para receber notificações de alteração do banco de dados de Cisco Unified CM IM e Presence | Erro |
| Erro de consulta do PEIDS | O Cisco Presence Engine serviço detectou um erro ao consultar o banco de dados de Cisco Unified CM IM e Presença | Erro |
| Memória PE em alta condição | Indica que o Cisco Presence Engine serviço atingiu um limite de memória alto | Erro |
| Falha na vinculação do soquete PESIP | Cisco Presence Engineo serviço não conseguiu se conectar à interface de ouvinte do SIP | Erro |
| Peste bloqueada | Cisco Presence Engineo serviço está administrativamente proibido de processar tráfego | Erro |
| Estado PE desativado | Cisco Presence Engineo serviço está inoperante e não consegue processar o tráfego | Erro |
| Falha na inicialização do PEWebDAV | Cisco Presence Enginefalha na tentativa de serviço de inicializar a biblioteca WebDAV | Erro |
| ESP interrompido | Cisco SIP Proxyo processo do service child foi interrompido | Erro |
| Falha na criação do ESPSharedMemCreate | Falha ao criar memória compartilhada | Erro |
| Falha no ESPSharedMemSetPerm | Falha ao definir permissões na memória compartilhada | Erro |
| Falha no ESPSharedMemAlloc | Falha ao alocar memória compartilhada | Erro |
| Erro ESP Config | Cisco SIP Proxyerro no arquivo de configuração do serviço | Erro |
| Configuração ESP não encontrada | Cisco SIP Proxyarquivo de configuração do serviço não encontrado | Erro |
| Falha no espCreateLock | Falha ao criar um arquivo de bloqueio | Erro |
| Erro de soquete ESP | Erros de soquete de rede encontrados | Erro |
| Falha na abertura do arquivo de log do ESPStats | Falha ao abrir o arquivo de registro de estatísticas | Erro |
| Falha no ESPM Alloc | Falha ao alocar memória | Erro |
| Endereço IP errado do ESPS | Endereço IP incorreto fornecido | Erro |
| Nome de host errado do ESP | Nome de host incorreto | Erro |
| Parâmetro passado pelo ESP inválido | Parâmetro inválido especificado | Erro |
| Registro inválido ESPNAPTR | Erro de formato de registro NAPTR | Erro |
| Erro do ESP Virtual Proxy | Virtual_Proxy_Domainerro relacionado. | Erro |
| Erro de registro do PE | Falha no registro SIP | Erro |
| Erro de eSprouting | Erro na interface de rota SIP | Erro |
| Erro de login do ESP | Erro no armazenamento de dados de login | Erro |
| Falha na localização do UASCB | Falha na localização do SCB | Erro |
| Falha no UASCBGET | SCB obtém ou cria falha | Erro |
| Módulo CTIGW não ativado | O módulo de aplicativo Cisco CTI Gateway não está configurado ou ativado | Erro |
| Provedor CTIGW inativo | O provedor de CTI está inativo | Erro |
| Usuário CTIGW não licenciado | O usuário não tem licença | Erro |
| Usuário do CTIGW não autorizado | Usuário não autorizado pelo CTI Gateway | Erro |
| Falha ao abrir o provedor CTIGW | Falha ao abrir o provedor CTI | Erro |
| Solicitação falhada do CTIGWQBE | Falha na solicitação do QBE | Erro |
| Erro do sistema CTIGW | Erros do sistema de aplicativos Cisco CTI Gateway | Erro |
| Falha na busca de PWSSCBFind | Falha na localização do SCB | Erro |
| Falha no PWSSCBINit | Falha na inicialização do SCB | Erro |
| PWS acima do limite de CPU | Indica que o Presence Web Service excedeu o limite de utilização da CPU | Erro |
| Limite de solicitação de PWS atingido | Limite de solicitação de serviço de proxy por segundo atingido | Erro |
| PWS acima do limite de assinatura SIP | Indica que a contagem de assinaturas do Presence Web Service excedeu o limite máximo | Erro |
| Falha na conexão SyncAgentAXL | Falha na autenticação do serviço Cisco Sync Agent | Erro |
| Erro NotInCucmServerList | Falha na inicialização do Cisco Sync Agent devido ao fato de o nó Cisco Unified CM IM e o Presence Server não estarem na lista de servidores do Cisco Unified Communications Manager editor. | Erro |
| Erro de conexão XCPTXTCONFDB | A camada de acesso a dados Cisco XCP não conseguiu se conectar ao banco de dados. | Erro |
| Erro de conexão do XCPDB | A camada de acesso a dados Cisco XCP não conseguiu se conectar ao banco de dados. | Erro |
| Erro de conexão XCPMessarchDB | A camada de acesso a dados Cisco XCP não conseguiu se conectar ao banco de dados. | Erro |
| Erro de conexão XCPM FTDB | A camada de acesso a dados Cisco XCP não conseguiu se conectar ao banco de dados. | Erro |
| Erro completo do xcptxtconfdb | A camada de acesso a dados Cisco XCP não conseguiu inserir dados no banco de dados devido ao espaço em disco/espaço de tabela insuficiente. | Erro |
| Erro completo do XcpMessArchDB | A camada de acesso a dados Cisco XCP não conseguiu inserir dados no banco de dados devido ao espaço em disco/espaço de tabela insuficiente. | Erro |
| Erro completo do XCPMFTDB | A camada de acesso a dados Cisco XCP não conseguiu inserir dados no banco de dados devido ao espaço em disco/espaço de tabela insuficiente. | Erro |
| Erro de conexão do componente XCPCM | O componente XCP falhou ao se conectar ao roteador XCP. O componente está sendo desligado. | Erro |
| Erro de conexão do componente XCPWEBCM | O componente XCP falhou ao se conectar ao roteador XCP. O componente está sendo desligado. | Erro |
| Erro de conexão do componente XCPSIPFEDCM | O componente XCP falhou ao se conectar ao roteador XCP. O componente está sendo desligado. | Erro |
| Erro de conexão do componente XCPXMPPFEDCM | O componente XCP falhou ao se conectar ao roteador XCP. O componente está sendo desligado. | Erro |
| Erro de configuração do componente XCPTXTCONF | O componente XCP detectou uma configuração incorreta. | Erro |
| Erro de inicialização do XCPM DNS | O roteador XCP falhou ao inicializar o MDNS. | Erro |
| Componente XCP Escreva um alarme em amarelo | Um dos componentes de E/S do roteador XCP relatou um aumento no número de pacotes (mais de 50K). | Erro |
| Intervalo de alarme de gravação do componente XCP | Um dos componentes de E/S do roteador XCP relatou um aumento no número de pacotes (mais de 80K). A entrega de pacotes pode ocorrer em breve! | Erro |
| Componente XCP grava alarme vermelho | Um dos componentes de E/S do roteador XCP relatou um aumento no número de pacotes (mais de 100K). A entrega de pacotes está em vigor agora! | Erro |
| Soquetes de pausa XCPCM | O roteador XCP orientou o XCP Connection Manager (CM) a pausar a escuta em seu soquete devido à carga no sistema. | Erro |
| Soquetes de pausa XCP WebCM | O roteador XCP orientou o XCP Web Connection Manager (CM) a pausar a escuta em seu soquete devido à carga no sistema. | Erro |
| Soquetes de pausa XCPCM | O roteador XCP orientou o XCP Connection Manager (CM) a pausar a escuta em seu soquete devido à carga no sistema. | Erro |
| Soquetes de pausa XCPSI PFEDCM | O roteador XCP orientou o XCP SIP Federation Connection Manager (CM) a pausar a escuta em seu soquete devido à carga no sistema. | Erro |
| Soquetes de pausa XCPXMPPFEDCMPAUSA | O roteador XCP orientou o XCP XMPP Federation Connection Manager (CM) a pausar a escuta em seu soquete devido à carga no sistema. | Erro |
| Erro de inicialização do XCPCM | Falha na inicialização do serviço XCP Connection Manager. | Erro |
| Erro de inicialização do XCP WebCM | Falha na inicialização do serviço XCP Web Connection Manager. | Erro |
| Erro de inicialização do XCPSIPFEDCM | Falha na inicialização do serviço XCP SIP Federation Connection Manager. | Erro |
| Erro de inicialização do XCPXMPPFEDCM | Falha na inicialização do serviço XCP XMPP Federation Connection Manager. | Erro |
| Erro de HTTP do XCPWebCMD | O serviço XCP Web Connection Manager tem erros na interface HTTP. | Erro |
| Erro XCPCMXMPPD | O serviço XCP Connection Manager tem erros na interface XMPP. | Erro |
| Conexões XCPCM por limite IP | O número de conexões de cliente XMPP de entrada aceitas por endereço IP atingiu o limite máximo especificado pela configuração. | Erro |
| Limite de IP de conexões XCP WebCM | O número de conexões aceitas de clientes web (BOSH) por endereço IP atingiu o limite máximo especificado pela configuração. | Erro |
| Limite de bytes de leitura do XCPCM | O número de bytes lidos de uma única conexão de cliente atingiu o limite máximo especificado pela configuração. | Erro |
| Limite de bytes de leitura do XCP WebCM | O número de bytes lidos de uma única conexão de cliente atingiu o limite máximo especificado pela configuração. | Erro |
| Erro de equipamento XCPtxtConf | O serviço XCP Text Conference Manager falhou ao carregar um equipamento configurado. | Erro |
| Erro XCPtxtConfdbQueueSizeLimit | O número de solicitações de banco de dados atingiu o limite máximo especificado pela configuração. | Erro |
| Erro XCPtxtconftcMessagesMSGID | Estado inválido da tabela tc_messages no banco de dados externo usado para bate-papo persistente. | Erro |
| Erro XCPSIPGWStackResource | O número de assinaturas ou segmentos de chamada simultâneos da Federação SIP S2S atingiu o limite máximo especificado pela configuração. | Erro |
| Erro de conexão de conformidade de terceiros do XCP | Cisco XCP Routernão consegue se conectar ao servidor de conformidade de terceiros | Erro |
| A reinicialização do XcpconfigMgrJabber é necessária | O Cisco XCP Config Manager regenerou os arquivos JabberXML após a parada do sistema devido ao tamanho do buffer. O roteador XCP agora deve ser reiniciado para receber as alterações. | Erro |
| Falha na configuração do XcpConfigMgr | O Cisco XCP Config Manager não consegue enviar a configuração para um componente. Verifique os registros. | Erro |
| Falha na resolução do XcpConfigMgrHostName | Falha na resolução do nome de host do gerenciador XCP Config | Erro |
| Falha na criptografia de senha XcpConfigMgrR2R | Falha na criptografia de senha do XCP Config Manager | Erro |
| O tempo limite da solicitação XcpConfigMGRR2R | O tempo limite da solicitação de configuração do XCP Config Manager R2R | Erro |
| Erro de montagem do XCPMFTextFSMount | O Cisco XCP File Transfer Manager perdeu sua conexão com o servidor de arquivos externo. | Aviso |
| XCPMFTextFSFreespaceWarn | O Cisco XCP File Transfer Manager detectou que o espaço em disco disponível no servidor de arquivos externo é baixo. | Aviso |
| Failover de SRM | O Cisco SRM está executando um failover automático | Aviso |
| Falha no SRM | Cisco Server Recovery Managerestá no estado de falha | Aviso |
| Falha na alteração do esquema de endereço IP de replicação | Esse alerta ocorre quando uma alteração do esquema de endereço de IM falha. | Aviso |
| Falha na alteração do domínio IP padrão de replicação | Esse alerta ocorre quando uma alteração do domínio de IM padrão local falha. | Aviso |
| ID de usuário duplicado | O Cisco IM and Presence Data Monitor detectou que dois ou mais usuários no sistema compartilham o mesmo valor de ID de usuário. | Aviso |
| URI do diretório duplicado | O Cisco IM and Presence Data Monitor detectou que dois ou mais usuários no sistema compartilham o mesmo valor de URI do diretório. | Aviso |
| URI de diretório inválido | O Cisco IM and Presence Data Monitor detectou que um ou mais usuários têm um valor de URI de diretório inválido. | Aviso |
| Sessões JSMS excedem o limite | Esse alerta ocorre quando o número de sessões do JSM excede o limite configurado para a sessão máxima definida pelo modelo OVA. Consulte o guia de configuração e administração de mensagens instantâneas e presenças - seção Monitoramento da capacidade do dispositivo para obter mais detalhes sobre o limite máximo de sessão definido por modelo OVA. | Aviso |
| Sem conexão com o Peer | Esse alerta ocorre quando o evento NoConnectionToPeer é gerado. Isso indica que uma conexão com um servidor de mesmo nível foi perdida. | Aviso |
| O failover automático foi bem-sucedido | Esse alerta ocorre quando o evento AutoFailoverSucceeded é gerado. Isso indica que um failover automatizado foi executado com êxito. | Aviso |
| Falha no failover automático | Esse alerta ocorre quando o evento AutoFailoverFailed é gerado. Isso indica que um failover automático foi tentado sem sucesso. | Aviso |
| O failback automático foi bem-sucedido | Esse alerta ocorre quando o evento AutoFailbackSucceeded é gerado. Isso indica que um failback automatizado foi executado com êxito. | Aviso |
| Falha no Failback automático | Esse alerta ocorre quando o evento AutoFailbackFailed é gerado. Isso indica que um failback automatizado foi automatizado sem sucesso. | Aviso |
| Falha no SBR | Esse alerta ocorre quando o evento sbrFailed é gerado. Isso indica que um procedimento de resolução de cérebro dividido invocado automaticamente retornou um erro. | Aviso |
| Consumo de disco próximo ao limite de capacidade | O consumo de espaço em disco está próximo do limite de capacidade do disco definido na página Configurações do sistema > Avançado > Capacidade do disco em Cisco Unity Connection Administração. O sistema não gravará novas mensagens se o consumo de disco atingir o limite. | Aviso |
| O consumo de disco excede o limite de capacidade | O consumo de espaço em disco atingiu o limite de capacidade do disco definido na página Configurações do sistema > Avançado > Capacidade do disco em Cisco Unity Connection Administração. O sistema não gravará novas mensagens quando o consumo de disco for igual ou superior ao limite. | Aviso |
| Aviso de licença expirada | Uma violação insuficiente da licença continuou além do período de carência. A operação do sistema será suspensa. Para obter detalhes, consulte a página de licença na Cisco Unity Connection administração do Unity Connection e o uso da licença na Enterprise License Manager administração. Reduza o uso para igualar os limites licenciados no Enterprise Licensing Manager ou adquira funcionalidades licenciadas adicionais. Quando o sistema estiver em conformidade novamente, será necessário reiniciar manualmente o sistema para restaurar a operação do sistema. | Aviso |
| Aviso de violação de licença | Ocorreu uma violação insuficiente da licença. Para obter detalhes, abra a tela Uso da Licença nas páginas da web de Enterprise License Manager administração. Se a violação da licença continuar além do período de carência, as operações do sistema serão suspensas. | Aviso |
| ELM não conectado | A conectividade com Enterprise License Manager o servidor está quebrada. Se a conectividade for perdida além do período de carência, as operações do sistema serão suspensas. | Aviso |
| Filial provisionada | A filial associada à conexão da unidade central foi provisionada com sucesso. | Aviso |
| DB quase cheio | O dBspace está quase cheio. Se o dBSpace ficar cheio, talvez o sistema não consiga fornecer todos os serviços. | Aviso |
| Falha no provisionamento da filial | O provisionamento de uma filial associada à conexão da unidade central falhou . | Aviso |
| Falha no provisionamento da filial MaxWait | O provisionamento da filial falhou devido ao tempo máximo de espera alcançado pela resposta de conclusão do provisionamento da filial. | Aviso |
| Falha no provisionamento de filiais no máximo de tentativas | O provisionamento de uma filial associada à conexão central falhou em todas as novas tentativas. | Aviso |
| Filial não acessível | A conectividade entre a central e a filial está interrompida. | Aviso |
| Central não acessível | A conectividade entre a filial e o escritório central está quebrada. | Aviso |
| Exceção de diretório do EvtReader | A sincronização de diretórios encontrou um erro de processamento interno. | Aviso |
| A fila de novas tentativas do EVT Reader está ficando cheia | Ao processar as alterações do objeto, o Reader não conseguiu aplicar essas alterações e colocá-las na fila de repetições. Essa fila agora está ficando cheia. | Aviso |
| EvterDesconectada | Esse alerta ocorre quando o alarme de desconexão ER é acionado pelo informix. | Aviso |
| Somente o Voice Name Reader Publisher | Essa instância da tarefa de sincronização de nomes de voz não foi executada porque foi iniciada em uma máquina assinante de um cluster. | Aviso |
| Leitor de nome de voz não encontrado | A tarefa de sincronização requer informações sobre o link de localização remota para sincronizar, mas não conseguiu encontrar as informações no banco de dados. | Aviso |
| Exceção do leitor de nome de voz | A sincronização do nome de voz encontrou um erro de processamento interno. | Aviso |
| Leitor não encontrado | A tarefa de sincronização requer informações sobre o link de localização remota para sincronizar, mas não conseguiu encontrar as informações no banco de dados. | Aviso |
| Somente para leitores e editores | Essa instância da tarefa de sincronização de diretórios não foi executada porque foi iniciada em um membro assinante de um cluster. | Aviso |
| Loop de rede do leitor detectado | Ao processar as alterações do objeto, o Reader não conseguiu aplicar essas alterações ao detectar um loop de rede. | Aviso |
| Diretório de leitores no domínio SMTP | O domínio SMTP é necessário para endereçar e transferir mensagens entre locais. A sincronização não será possível até que o domínio SMTP seja configurado no site/local remoto. | Aviso |
| Erro de acesso ao feed do Reader Directory | O feed de objetos de localização Bridgehead/HTTP (S) entre sites contém as informações de diretório necessárias para permitir o endereçamento de mensagens aos usuários em sites/locais remotos. Um erro durante a recuperação do feed de objetos impede a sincronização total com o site/local remoto. | Aviso |
| Erro de feed de informações do leitor | A tarefa de sincronização tenta baixar o status do site/local remoto, mas essas informações de status não estavam disponíveis no momento. | Aviso |
| Falha no removedor de rede | O link do site remoto não pode ser excluído porque todos os objetos sincronizados com o site remoto não foram removidos. | Informativo |
| Erro do removedor de rede | A tarefa “Remover objetos associados a sites remotos excluídos” encontrou um erro. Isso pode ser resultado de outra atividade no sistema. A próxima execução da tarefa pode não encontrar o mesmo problema. | Informativo |
| Estouro de diretório do EVT Reader | O número de objetos de diretório nesse local ultrapassou o limite suportado. | Informativo |
| Modo de alerta de sincronização de diretórios | Localização HTTP (S) A máquina Publisher está atualmente inacessível, embora a sincronização de diretórios esteja sendo feita com sua máquina assinante. | Informativo |
Regra de alerta de eventos de anomalia baseada em IA
Use essa regra para receber alertas baseados em IA para cenários de serviços de aplicativos de UC, como anomalias relacionadas a quedas de registros, volume de chamadas e falhas de chamadas.
Como criar uma regra
- Entre no Control Hub e acesse Notificações > Minhas regras.
- Clique em Criar regra.
- Na seção Resumo, configure a regra de alertas do aplicativo UC.
- Na lista de serviços, escolha Chamando.
- Na lista de tipos, escolha os eventos de anomalia baseados em IA da Cloud Intelligence.
- Selecione a severidade preferida.
- Esse campo mostra a gravidade ou a importância de um alerta. Você pode escolher o nível de severidade como Alto, Médio ou Baixo.
- Consulte a seção Tabela de severidade para saber mais sobre o Control Hub e a gravidade do tipo de alerta.
- Consulte a tabela da lista de anomalias de IA para saber mais sobre os diferentes nomes, descrições e níveis de severidade do alerta.
- Insira um título para a nova regra e verifique se a opção de alertas está ativada .
- Verifique se o botão de alertas está ATIVADO para receber notificações do
alerta.
Quando DESATIVADO, os usuários não receberão alertas.
- Na seção Destino, selecione um ou mais clusters de aplicativos Cisco Unified Call Manager para receber alertas de anomalias baseados em IA.
- Na seção Definição de regras, crie uma regra para ser notificado sobre
anomalias detectadas pela IA em chamadas e atividades de registro telefônico. Escolha os eventos para o cluster de aplicativos de
UC selecionado que você deseja monitorar. Os eventos são
- Falhas de chamadas — Receba alertas sobre anomalias de falhas de chamadas detectadas em relação aos dados previstos, incluindo picos inesperados de falhas de chamadas.
- Volume de chamadas — Receba alertas sobre anomalias de falhas de chamadas detectadas em relação aos dados previstos, incluindo picos inesperados de falhas de chamadas.
- Queda do registro telefônico — Receba alertas sobre anomalias de queda no registro telefônico detectadas em clusters e pool de dispositivos em relação aos dados previstos.
- Na seção Canal de entrega, escolha como receber os alertas:
- E-mail— Insira os endereços de e-mail de quem receberá os alertas.
- Espaço Webex— Digite o nome do espaço para receber o alerta como mensagens em
um espaço. O bot só envia mensagens aos destinatários que são adicionados ao canal de entrega de e-mail.
Sua organização deve ter o sistema de mensagens habilitado para que o aplicativo Webex use um espaço como canal de entrega.
- Webhook— Marque essa caixa de seleção se quiser usar o alerta com aplicativos de terceiros.
- Clique em Salvar.
Depois que as regras são criadas, são necessárias no máximo 6 horas para começar a receber as notificações.
Para dispositivos, você pode criar regras para receber alertas para:
- Eventos offline e online — Um evento é registrado após um dispositivo ficar off-line por 5 minutos ou ter voltado a ficar on-line há 5 minutos. Você pode criar até 100 desses alertas.
- Problemas detectados ou eventos resolvidos — Você pode selecionar se deseja receber todos os alertas ou silenciar aqueles que não deseja receber. Você pode criar até 100 desses alertas.
- Expiração da versão do software — Um alerta é enviado 14 dias e 3 dias antes da expiração da versão do software para o dispositivo. Você pode criar até 10 desses alertas
Consulte os alertas de dispositivos RoomOS no artigo do Control Hub para obter mais detalhes sobre os alertas disponíveis e como configurá-los para dispositivos Board, Desk e Room Series em sua organização.
Alertas de telefones PhoneOS no Control Hub
Como administrador, você pode verificar o status dos telefones registradosWebex Calling. Se ocorrer algum problema no telefone, você poderá ver os detalhes na seção Problemas e informações em Dispositivos para diagnóstico e solução de problemas.
Além disso, você pode ver todos os alertas relatados pelo telefone em Notificações. Para obter mais informações sobre notificações, consulte Notificações no Control Hub.
Protocolo de chamada
| Nome de exibição | Código | Tipo | Mensagem | Nível |
|---|---|---|---|---|
| Serviço limitado | serviço limitado wxc | Serviço limitado | Modo SRST - este telefone tem serviço limitado.
A mensagem também pode ser exibida na tela do telefone. | Aviso |
| Registro de perfil Sip | Registro de perfil SIP | Falha no registro do SIP | Falha no registro do SIP | Erro |
Rede
| Nome de exibição | Código | Tipo | Mensagem | Nível |
|---|---|---|---|---|
| Perda de pacotes detectada | qualidade da rede | Perda de pacotes detectada | Durante a última chamada, detectamos um nível de perda de pacotes que pode ter afetado a qualidade da chamada. A perda de pacotes geralmente é causada pelo congestionamento da rede. | Aviso |
Botão de ação
| Nome de exibição | Código | Tipo | Mensagem | Nível |
|---|---|---|---|---|
| Botão de ação não configurado | botão de ação não configurado | Botão de ação não configurado | O botão Ação não está configurado. Configure-o em Todas as configurações > Telefone > Botão de ação. | Aviso |
| Serviço de emergência com botão de ação indisponível | emergência indisponível | Serviço de emergência com botão de ação indisponível | É impossível acessar o serviço de emergência, pois nenhuma linha está registrada. Não conseguirá usar o botão Ação ou discar números para acessar o serviço. | Aviso |
Segurança
| Nome de exibição | Código | Tipo | Mensagem | Nível |
|---|---|---|---|---|
| Falha na inscrição do certificado SCEP | falha na inscrição do scepcert | Falha na inscrição do certificado SCEP | Falha na inscrição do certificado SCEP | Erro |
Configuração
| Nome de exibição | Código | Tipo | Mensagem | Nível |
|---|---|---|---|---|
| Falha ao aplicar as alterações de configuração | falha na sincronização do wxcresync | Falha ao aplicar as alterações de configuração | O telefone falhou ao aplicar as alterações de configuração. As configurações podem estar desatualizadas. | Erro |
| Falha na atualização | falha no wxcupgrade | Falha na atualização | O telefone não conseguiu atualizar o firmware. Verifique se o dispositivo tem uma conexão de rede ativa, se o DNS está configurado e se não está bloqueado por firewalls ou proxies. | Erro |
Use as notificações do Agent Central no Control Hub para revisar as alterações no servidor e nos recursos do Agentic Apps que podem afetar o acesso da sua organização. As notificações do Agent Central aparecem quando um servidor público ou privado habilitado da Agentic Apps muda de uma forma que exige conhecimento ou análise do administrador.
Você deve ser administrador do Control Hub com acesso às Notificações para visualizar os alertas do Agent Central para aplicativos da Agentic e gerenciar a regra de entrega dos alertas gerados.
No Control Hub, os alertas do Agentic Apps e as regras geradas aparecem com o nome do Agent Central. Pesquise o Agent Central ao filtrar alertas ou regras.
Todos os alertas do Agent Central para aplicativos da Agent aparecem no Control Hub. Alertas bloqueados de alta severidade também podem ser entregues por e-mail ou em um espaço do aplicativo Webex quando você configura a entrega para a regra gerada. Os alertas de aviso de baixa severidade aparecem somente em Notificações.
A detecção repetida da mesma alteração não resolvida não gera alertas duplicados. Se o problema for resolvido e o servidor mudar novamente mais tarde, o Control Hub cria um novo alerta para a nova alteração.
Exibir alertas do Agent Central para aplicativos da Agentic
Você deve ser administrador do Control Hub com acesso às Notificações.
| 1 |
Faça login no Control Hub. |
| 2 |
Vá para Notificações > Alertas. |
| 3 |
Selecione Todos os alertas para ver os alertas da sua organização ou Meus alertas para ver os alertas entregues a você. |
| 4 |
Use a pesquisa ou os filtros para encontrar alertas do Agent Central. |
| 5 |
Selecione a linha de alerta para ver os detalhes do alerta ou selecione Revisar servidor para abrir o servidor Agentic Apps afetado. |
Tipos de alerta do Agent Central
Os alertas do Agent Central para aplicativos da Agentic informam se o acesso pode continuar com um aviso ou se está bloqueado até que um administrador revise a alteração.
| Tipo de alerta | Severidade | O que isso significa | O que fazer |
|---|---|---|---|
| Aviso de comunicação de metadados | Baixo | O nome do servidor, a descrição ou o URL do mesmo domínio foram alterados e o acesso pode continuar até a revisão. | Revise o servidor e aprove novamente os metadados ou desative o servidor se você não confiar na alteração. |
| Comunicação de metadados bloqueada | Alto | Uma alteração no nível do servidor bloqueia o acesso. Isso pode incluir um novo domínio de URL, uma alteração de metadados bloqueada, alterações na segurança ou na interface do Agent Card ou um crachá de servidor inválido. | Revise e aprove novamente o servidor, siga as orientações da página do servidor para problemas com crachás ou desative o servidor. |
| Aviso de comunicação de capacidade | Baixo | Uma ferramenta, solicitação, recurso ou habilidade ativada foi alterada e sua organização permite que o acesso continue até a revisão. | Revise e aprove novamente o recurso afetado ou desative-o. |
| Capacidade de comunicação bloqueada | Alto | Uma ferramenta, solicitação, recurso ou habilidade habilitada foi alterada e sua organização não permite que o acesso continue, ou um item ativado foi removido ou renomeado. O acesso ao item afetado está bloqueado. | Analise e reaprove os recursos afetados ou desative os itens afetados. |
Se a mesma atualização detectar alterações de aviso e de capacidade bloqueada, o Control Hub exibirá um alerta de bloqueio de alta severidade com os dois estados listados nos detalhes do alerta. Por exemplo, um alerta bloqueado pode incluir duas ferramentas com o status Bloqueado e um prompt com o status Aviso.
Os servidores registrados não geram alertas do Agent Central até serem aprovados e habilitados para sua organização. Novas ferramentas, solicitações, recursos ou habilidades que não foram habilitados para sua organização não acionam alertas do Agent Central.
Revise e resolva os alertas do Agent Central
Use o servidor de revisão a partir de um alerta para inspecionar o servidor ou o recurso afetado do Agentic Apps.
| 1 |
Faça login no Control Hub. |
| 2 |
Vá para Notificações > Alertas. |
| 3 |
Procure por Agent Central. |
| 4 |
Abra o alerta que você deseja revisar. |
| 5 |
Selecione Servidor de revisão. |
| 6 |
Analise os metadados, a ferramenta, a solicitação, o recurso ou a habilidade do servidor afetado. |
| 7 |
Escolha uma das seguintes ações:
|
O Control Hub limpa o alerta ativo depois que o problema é corrigido, desativado ou reaprovado. Marcar manualmente uma linha do Centro de alertas como resolvida não aprova metadados, restaura um selo nem desbloqueia um recurso afetado. Se o problema subjacente ainda estiver presente, o Control Hub poderá criar um novo alerta ao detectar novamente a alteração não resolvida.
Exibir as regras de alerta do Agent Central
As regras de alerta do Agent Central para aplicativos da Agentic são geradas automaticamente pelo Webex e aparecem no serviço Geral. Essas regras geradas são somente para leitura para nome de regra, severidade, serviço e condições de gatilho. Para regras de bloqueio de alta severidade, você pode configurar canais de entrega e destinatários.
| 1 |
Faça login no Control Hub. |
| 2 |
Vá para Notificações > Alertas. |
| 3 |
Selecione Todas as regras. |
| 4 |
Procure por Agent Central. |
Configurar a entrega para alertas de alta severidade do Agent Central
Alertas bloqueados de alta severidade podem ser entregues por e-mail ou em um espaço do aplicativo Webex. O Control Hub sempre recebe o alerta, mesmo se você não adicionar um e-mail ou destinatário do aplicativo Webex.
| 1 |
Faça login no Control Hub. |
| 2 |
Vá para Notificações > Alertas. |
| 3 |
Selecione Todas as regras. |
| 4 |
Procure por Agent Central. |
| 5 |
Abra uma das regras de bloqueio de alta severidade: comunicação de metadados do Agent Central bloqueada ou comunicação de recursos do Agent Central bloqueada. |
| 6 |
Em Canal de entrega, selecione E-mail e adicione os destinatários do e-mail. |
| 7 |
Para enviar alertas em um espaço do aplicativo Webex, selecione o espaço Webex e escolha a opção de entrega de espaço. |
| 8 |
Salve a regra. |
Notas e limitações das notificações do Agent Central
Lembre-se dessas notas e limitações ao usar as notificações do Agent Central para aplicativos da Agentic.
- Os alertas do Agentic Apps aparecem com o nome do Agent Central no Control Hub.
- Os alertas de aviso de baixa severidade são apenas para a Central de Alertas.
- Alertas bloqueados de alta severidade podem ser entregues por e-mail ou espaço do aplicativo Webex se a entrega estiver configurada na regra gerada.
- Servidores registrados, mas não habilitados, não geram alertas do Agent Central.
- Os novos recursos upstream que não foram habilitados para sua organização não acionam alertas do Agent Central.
- A detecção repetida da mesma alteração não resolvida não cria alertas duplicados.
- Os alertas do servidor público têm como escopo cada organização habilitada afetada.
- Os alertas do servidor privado são direcionados para a organização proprietária depois que o servidor é aprovado e ativado.
- Quando um problema de metadados no nível do servidor bloqueia o acesso, o Control Hub pode mostrar o alerta de bloqueio de metadados em vez de alertas de capacidade separados até que o problema no nível do servidor seja resolvido.
Você pode configurar um URL de retorno de chamada do webhook para que os alertas apareçam em aplicativos de terceiros. O administrador pode especificar um URL de retorno de chamada do webhook no Control Hub. Depois de fornecer um URL de retorno de chamada, você pode selecionar a opção webhook como um canal de entrega adicional nas regras para alertas novos ou existentes. Veja abaixo as etapas sobre como configurar webhooks.
Aqui está um exemplo da aparência do elemento JSON para um webhook de alerta:
{
"orgId": "1ab23cde-4567-890f-1234-gh56ijk07l891",
"title": "title",
"summary" : "notification for a test alert",
"actionUrl" : "www.actionURL.com",
"severity" : "HIGH",
"eventType" : "created",
"resourceType": "ControlHubAlerts",
"type": "Meeting",
"subtype": "Live Meeting Monitoring",
}
Configurar um URL de retorno de chamada do webhook
Você deve primeiro adicionar um URL de retorno de chamada do webhook antes de ativar as regras para usar os webhooks.
| 1 |
Faça login no Control Hub e acesse as Configurações da organização. |
| 2 |
Role até a seção de configuração do Webhook. |
| 3 |
Ative a opção Configurar o URL do webhook. Uma janela pop-up é exibida. |
| 4 |
Insira o URL do webhook que você deseja usar. Você também pode optar por adicionar um token secreto para o webhook. Veja este blog para saber mais sobre tokens secretos. 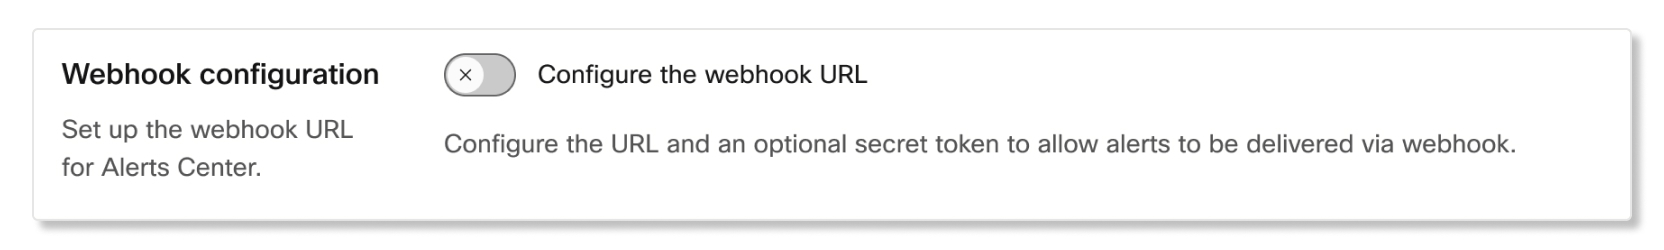
|
| 5 |
Selecione Validar. Se a validação falhar, verifique se o URL do webhook e o token secreto estão corretos. Clique em Tentar novamente quando terminar a verificação. |
| 6 |
Selecione Salvar. |
Habilitar webhook em uma regra
Depois de configurar um URL de webhook, você pode configurar regras para usar webhooks como um canal de entrega.
| 1 |
Entre no Control Hub e acesse Notificações > Minhas regras. |
| 2 |
Na guia Todas as regras, selecione uma regra. |
| 3 |
Na seção Método de entrega, marque a caixa de seleção Webhook. Com base no tipo de alerta que você está criando, um exemplo de carga útil é exibido para que você saiba o que esperar. 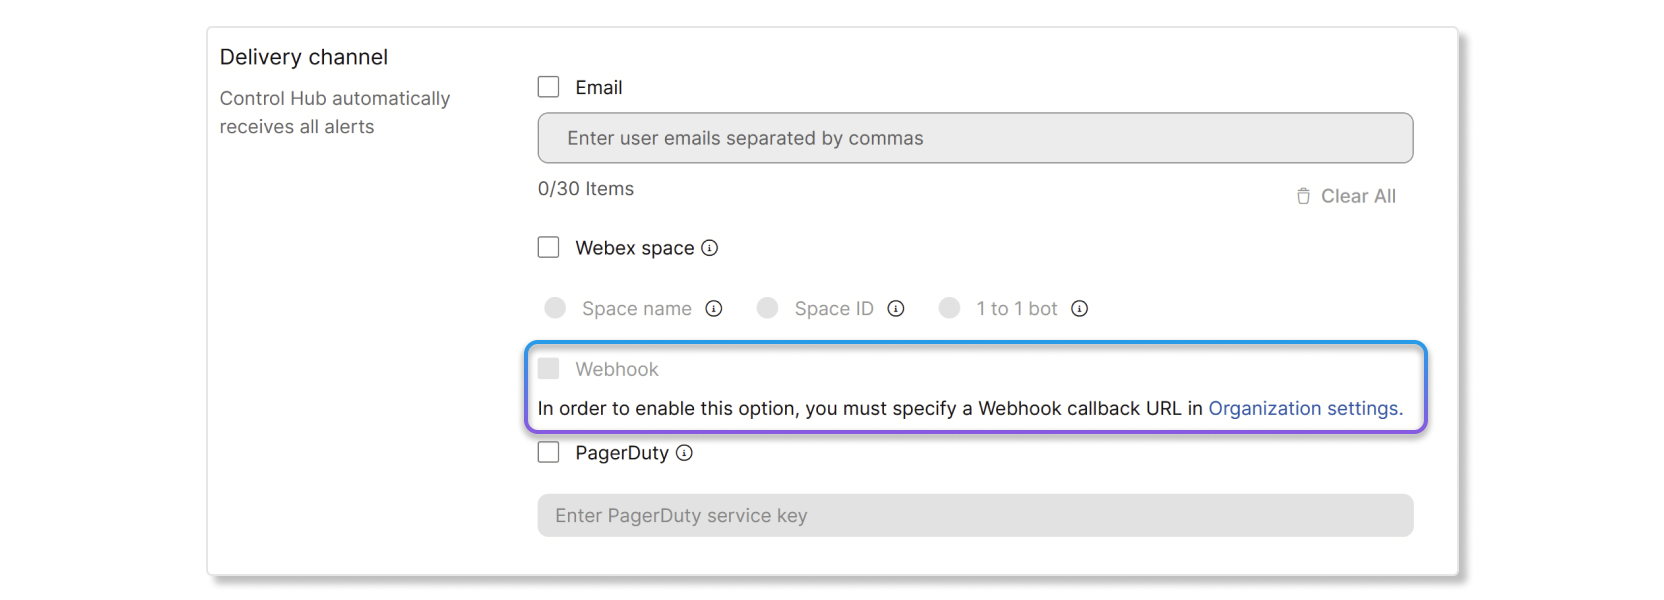
|
| 4 |
Clique em Salvar. |
Referência de campo de webhook de dispositivos Cisco
Para obter informações sobre referências de campo de webhook para dispositivos Cisco, consulte este artigo.
Você pode configurar uma chave de integração do PagerDuty para que os alertas apareçam em aplicativos de terceiros .
Habilitar o PagerDuty em uma regra
Antes de começar
Você deve primeiro obter uma chave de integração no PagerDuty antes de ativar a configuração do PagerDuty para alertas no Control Hub. Para obter uma chave de integração, crie um novo serviço no PagerDuty e selecione Events API V2 como integração. Depois de criar um serviço da Events API V2, você pode encontrar a chave de integração na guia Integrações do painel do PagerDuty.
| 1 |
Entre no Control Hub e acesse Notificações > Minhas regras. |
| 2 |
Na seção Canal de entrega, marque a caixa de seleção PagerDuty. |
| 3 |
Insira a chave de integração que você criou no painel do PagerDuty. |
| 4 |
Clique em Salvar. |


